Automatisation, chatbot ou agent : ce que vous achetez
Automatisation, chatbot et agent ne sont pas la même chose et n'échouent pas pareil. Ce qu'est chacun, ce qu'il coûte et lequel votre problème demande.


Ce que les agents d'OpenAI ont fait avec Navier-Stokes, pourquoi 28 médaillés Fields signent une déclaration qui émet des réserves sur la façon dont on utilise l'IA en mathématiques et pourquoi « elle ne fait que répéter ce qu'elle a lu » ne tient plus
Marc Galera
Cofondateur de Qvasar ·
Le samedi 5 septembre 2026, environ 88 heures après leur lancement, quelque 10 000 agents d'OpenAI ont abouti à une solution de Navier-Stokes, les équations par lesquelles la physique décrit le mouvement d'un fluide. Des agents : des programmes dotés d'IA qui travaillent seuls, sans que personne ne dirige chaque étape. Ils ont travaillé en même temps et ont échangé 2,7 millions de messages. Faire passer la démonstration par un programme qui la vérifie étape par étape leur a pris 17 heures de plus.
Ce n'était pas un tir à l'aveugle. Chez OpenAI, on entraînait depuis le 28 août un nouveau modèle qui, de leur propre aveu, avait fait un bond de performance, et, ce bond en main, ils ont décidé de l'essayer sur tous les problèmes du millénaire encore ouverts : les grandes questions des mathématiques pour lesquelles l'Institut Clay offre un prix. C'est d'abord une variante des équations d'Euler qui est tombée, celle d'un fluide que personne ne pousse de l'extérieur, sur laquelle près de cent agents ont travaillé pendant une cinquantaine d'heures. Au vu de ce résultat, OpenAI a conclu que Navier-Stokes était le problème le plus prometteur et y a concentré ses ressources.
Le 8 septembre, OpenAI l'a rendu public. Dit sans formules : un fluide qui part lisse et au repos, auquel on applique une force lisse et dont l'énergie reste finie, peut atteindre en un temps fini un point où sa vitesse croît sans limite. Les mathématiciens appellent cela une singularité. L'énoncé officiel de l'Institut Clay demande de démontrer l'un quelconque de quatre énoncés, et OpenAI affirme en avoir démontré deux. Une machine, ou dix mille à la fois, venait de revendiquer l'un des grands problèmes ouverts des mathématiques.
Pourtant, quand je dis aux gens que l'IA génère déjà des connaissances nouvelles, ils me regardent de travers. Avec d'autres, c'est l'inverse : ce que je fais leur paraît aller de soi.
Ce que je fais, ces 7 à 10 derniers jours, c'est ceci. J'ai consommé environ 100 milliards de tokens (les morceaux de texte que facture un modèle) entre les trois fournisseurs de modèles que j'utilise : deux abonnements Claude Max x20, à 200 dollars chacun, un de GLM, à 168 dollars, et un de ChatGPT, à 85 euros. Ce sont des abonnements mensuels, mais il se trouve que ces jours-ci je les ai tous actifs en même temps, pour des raisons de travail. J'ai avancé comme jamais : j'ai produit du contenu de grande qualité, en sites web, vidéos, marketing et articles, et j'ai créé plusieurs harnesses (l'assemblage d'instructions et d'outils avec lequel je prépare un modèle pour un travail) et plusieurs sites web. C'est aussi stressant, et ça rend très accro.
Sur les connaissances nouvelles, la réponse que j'entends le plus est presque toujours la même : « Non, mais c'est probabiliste. Toutes les connaissances qu'elle te génère, elle les génère à partir des connaissances humaines qui existent déjà ». L'objection a une version sérieuse. En 2021, Emily M. Bender, Timnit Gebru et deux coautrices l'ont formulée dans un article, « On the Dangers of Stochastic Parrots ». Selon elles, un modèle de langage (le type de programme qui fait tourner ChatGPT ou Claude) coud des suites de mots vues dans ses données d'entraînement, en se guidant sur des probabilités et sans aucune référence au sens. Elles l'ont appelé perroquet stochastique : un perroquet qui répète par statistique.
Ce n'est plus vrai, du moins pas sous la forme où on me le dit. Que ces modèles s'appuient sur ce que nous, les humains, savons, c'est exact. Qu'ils ne puissent pour autant rien produire que nous ne sachions déjà, non. Nous en sommes déjà au point où ils génèrent des connaissances nouvelles, et c'est, pour moi, la démocratisation de l'intelligence : qu'une capacité qui, il y a peu encore, était à la portée de très peu de gens arrive à quiconque peut payer un abonnement. Le reste de l'article explique pourquoi, avec les cas et leurs bémols, car il y en a.
Et cela vous concerne même si vous ne lirez jamais une équation de fluides. Le modèle qui signe le résultat sur Navier-Stokes n'est pas à vendre : il est interne, et OpenAI le décrit comme nettement plus capable que son modèle public. Mais ce modèle public existe. Quand OpenAI a présenté GPT-6 Astra, le 3 septembre, l'entreprise a dit qu'il avait déjà aidé à résoudre des problèmes ouverts de mathématiques, et a annoncé qu'elle l'ouvrirait en quelques jours à tous les utilisateurs de ChatGPT Plus, l'offre à 20 dollars par mois.
Les centaines de résultats qu'OpenAI a publiés en octobre ont consommé en moyenne, chacun, l'équivalent d'environ trois heures de raisonnement de ChatGPT Pro, son abonnement cher. Si un perroquet ne fait que répéter ce qu'il a entendu, comment trouve-t-il quelque chose qui n'était écrit nulle part ?
L'autre moitié de l'histoire ne figurait pas dans l'annonce. Le 11 septembre, l'Institut Clay a publié un communiqué qui ne nommait ni OpenAI ni personne. Il disait prendre acte de l'annonce selon laquelle le problème avait été « apparemment » résolu, et que son évaluation se ferait délibérément sans hâte. Ses règles ne sont pas pressées : la solution doit paraître dans une publication qui remplit ses critères, au moins deux ans doivent s'écouler et la communauté mathématique doit l'avoir acceptée. OpenAI, de son côté, a dit ne pas avoir l'intention de réclamer le prix. À la mi-octobre, au moment où j'écris ces lignes, je n'ai trouvé aucune validation indépendante publiée de sa preuve.
Le 7 septembre, la veille de l'annonce, le mathématicien Terence Tao écrivait sur son blog à propos du travail de Tristan Buckmaster, professeur à l'Université de New York, et de Levent Alpöge, employé d'Anthropic, l'entreprise de Claude. Ils avaient démontré que trois autres équations de fluides, dont celle d'Euler, peuvent exploser en un temps fini, c'est-à-dire atteindre l'une de ces singularités, quand on leur applique une force lisse. Tao jugeait très probable que leur méthode s'étende aussi à Navier-Stokes.
Eux aussi avaient travaillé avec l'IA. Buckmaster raconte qu'ils ont utilisé Claude, d'Anthropic, et Codex, d'OpenAI, et qu'Astra ne leur a servi qu'à rédiger et relire leurs arguments. Pour lui, l'important est qu'un mathématicien avec un modèle de langage puisse faire tout ce travail en un mois. Le mérite de l'idée de départ, écrit-il, revient à Diego Córdoba, de l'Instituto de Ciencias Matemáticas du CSIC, et à Luis Martínez-Zoroa, de CUNEF Universidad. Alpöge et Buckmaster ont pris le travail de Córdoba et de Martínez-Zoroa comme point de départ. Selon Quanta Magazine, Charles Fefferman, l'auteur de l'énoncé officiel du problème, a dit que les héros de cette histoire, ce sont eux deux.
OpenAI a reconnu l'antériorité d'Alpöge et de Buckmaster sur la version d'Euler avec force et les a félicités, tout en soulignant que son système avait prouvé la version sans force. La partie amère se trouve dans le texte même de Buckmaster. Il raconte qu'on avait assuré à Alpöge qu'il y avait eu « très peu d'intervention humaine », et que cela s'est révélé faux. Et que, quand il a prévenu qu'il rendrait public ce qui s'était passé, la réponse qu'il a reçue lors d'un appel avec OpenAI a été : « Pourquoi ruineriez-vous votre carrière ? ». Il précise lui-même qu'il n'accuse personne de rien.
Voici donc la répartition. Le système d'OpenAI a démontré la variante d'Euler sans force et revendique Navier-Stokes, en attendant ce que dira l'Institut Clay. Alpöge et Buckmaster, à partir du travail de Córdoba et de Martínez-Zoroa, ont démontré la variante avec force, et Tao pense que leur méthode peut aller jusqu'à Navier-Stokes. Les deux équipes ont utilisé des modèles de langage. Avant de se demander qui l'a résolu, il faut se poser une autre question : comment savons-nous que c'est juste ?
Une démonstration que personne n'avait écrite auparavant se vérifie avec un programme, et dans les annonces d'OpenAI revient sans cesse le même : Lean. L'entreprise le définit comme un langage de programmation qui permet à un ordinateur de vérifier des démonstrations mathématiques. Imaginez-le comme un relecteur qui ne fait confiance à personne et reprend chaque étape jusqu'au début : chaque affirmation doit s'appuyer sur une preuve qui descend jusqu'aux axiomes, les règles de départ que l'on accepte sans les démontrer. Les dépôts d'OpenAI, les dossiers publics où elle met ses fichiers en ligne, expliquent comment vérifier ses preuves avec Comparator, un outil conçu précisément pour le cas où la preuve est apportée par quelqu'un qui essaie de vous convaincre qu'il a démontré quelque chose.
C'est là que tombe la moitié de l'objection. Que le modèle fonctionne par probabilités décrit sa façon d'écrire, pas si ce qu'il écrit est correct. Une démonstration se vérifie de la même manière d'où qu'elle vienne, et peu importe à Lean qu'elle ait été écrite par une professeure titulaire ou par dix mille agents.
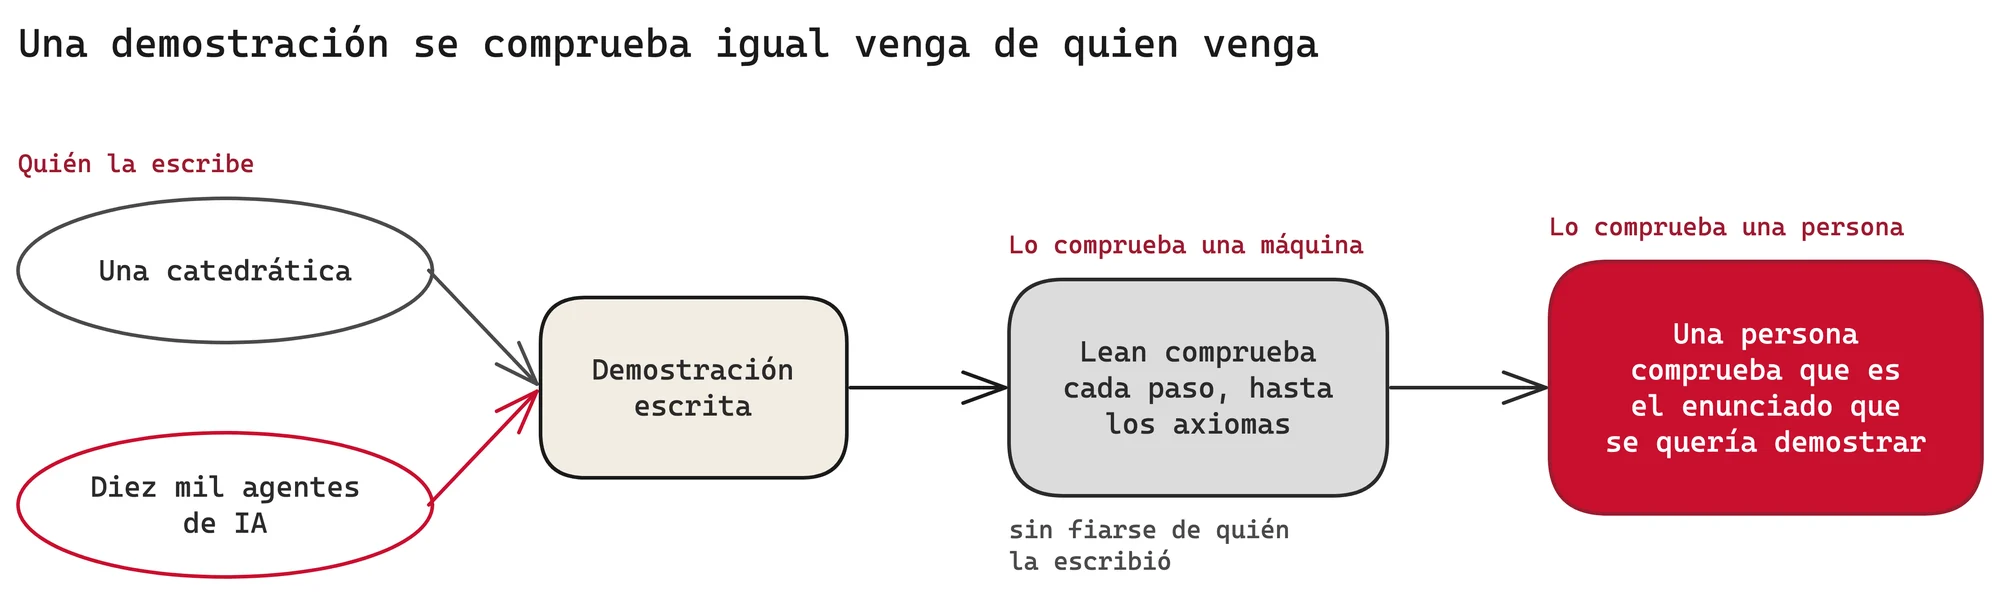
Lean a aussi des limites, et elles sont documentées. Comparator part du principe que la pièce centrale de Lean, celle qui fait les vérifications, n'a pas d'erreurs. Et la part qui reste aux personnes, selon Quanta Magazine, c'est de s'assurer que ce que Lean tient pour démontré est vraiment ce qu'on voulait démontrer. C'est là que vise une critique du résultat sur Navier-Stokes : le 6 octobre, Bastounis, Circelli et Hansen ont publié que la version de la preuve que vérifie Lean ne correspond pas à la preuve écrite en langage courant, si bien que le texte peut contenir des arguments erronés même si Lean tient le théorème pour correct. Tous trois précisent qu'ils n'affirment pas que la preuve d'OpenAI est fausse : ils disent que sa traduction en Lean n'est pas fidèle.
Le dépôt qu'OpenAI a publié en octobre montre les deux faces. Le 6, elle a mis en ligne 722 manuscrits, regroupés en 372 familles de résultats apparentés, issus d'environ 4 000 problèmes soumis à un modèle interne. Le lendemain, elle en a retiré trois, parce qu'une erreur de signe invalidait un argument et deux articles qui en dépendaient, et en a corrigé quatorze autres. Sur les 719 restants, 300 sont vérifiés en Lean, environ 42 %.
Pour ne pas s'embrouiller avec les chiffres du dépôt, les chiffres exacts sont ceux-ci : 372 familles de résultats et 300 résultats principaux vérifiés par machine. Le dépôt lui-même prévient que certains de ceux qui ne sont pas vérifiés pourraient poser problème. Bon, nous savons comment vérifier qu'une démonstration est correcte. Mais est-elle nouvelle, ou est-ce une copie bien faite de ce que nous savions déjà ?
La meilleure façon de répondre est d'écouter ceux qui protestent le plus. Le 1er août, OpenAI a publié dix résultats obtenus par une version interne d'Astra et a dit que chacun résolvait, ou faisait avancer de façon substantielle, un problème ouvert depuis longtemps. Selon l'entreprise, les tokens nécessaires pour trouver les dix solutions, l'unité dans laquelle se facture l'usage du modèle, coûteraient environ 2 000 dollars aux tarifs de l'API de Sol.
Les critiques sont arrivées en quelques jours. Stephen Miller, professeur de mathématiques à l'Université Yeshiva, a dit à Scientific American qu'OpenAI fait délibérément l'impasse sur le travail des autres, et que cela laisse soupçonner une faute scientifique. Selon la revue, l'une des preuves présentait comme sien un argument que Miller et un collaborateur avaient publié en 2016. La version corrigée de l'annonce, du 6 août, cite désormais ce travail.
Le mathématicien Francesco Fournier-Facio a été plus nuancé dans un article à lui. Il écrit que la pièce maîtresse d'un autre des dix résultats s'appuie de façon cruciale sur des travaux antérieurs, de 2019, et ajoute malgré tout deux choses. Que les experts qui connaissaient ces travaux auraient probablement pu le démontrer, même si l'idée de poser la question ne leur serait peut-être pas venue. Et que les modèles n'ont de limites ni de temps ni de ressources, si bien qu'ils peuvent essayer des choses jusqu'à voir laquelle fonctionne. Andreas Thom, l'un des auteurs de ces travaux de 2019, a décrit la construction d'OpenAI comme à la fois créative et élémentaire, et a écrit qu'il cherchait un tel mécanisme depuis cette époque. Le 7 août, six jours après l'annonce, il avait déjà publié avec un collègue un nouvel article qui part d'une proposition d'OpenAI.
Le cas le plus net commence en 1946. Paul Erdős a alors formulé une conjecture (une affirmation tenue pour vraie sans être démontrée) sur les distances dans le plan. Quatre-vingts ans ont passé. En mai 2026, un modèle interne d'OpenAI l'a réfutée, et la preuve a été relue par neuf mathématiciens extérieurs. L'un d'eux, Tim Gowers, a écrit que c'est sans aucun doute un jalon des mathématiques faites par l'IA, et que, si un humain l'avait envoyée à la revue Annals of Mathematics, il aurait recommandé de l'accepter sans hésiter. Les relecteurs notent que l'argument s'appuie sur des idées qu'on peut, avec le recul, attribuer à des travaux d'autres chercheurs. Et Gowers précise qu'un contre-exemple, un cas concret qui démontre qu'une règle générale est fausse, est justement ce qu'un ordinateur pourrait trouver à force d'essayer beaucoup et d'avoir de la chance.
Avec cela, on peut déjà répondre à la question du perroquet. Ces démonstrations s'appuient sur des travaux antérieurs, et celle de mai a été relue par neuf mathématiciens extérieurs. Cela n'en fait pas des copies : c'est aussi ainsi que se construit une démonstration humaine. Terence Tao l'a résumé en octobre, dans un recueil de réactions : beaucoup de ces preuves semblent apporter des idées nouvelles et ingénieuses qui porteront leurs fruits, et s'appuient en même temps sur les apports d'innombrables mathématiciens humains.
Le modèle ne tire rien du néant. Il essaie des combinaisons sans se lasser jusqu'à tomber sur celle qui fonctionne, et dans l'un des dix résultats d'août, selon Fournier-Facio, il est arrivé à un énoncé que les experts n'auraient peut-être pas eu l'idée de poser. C'est nouveau, et c'est fait avec nos pièces.
Le signal le plus fort est signé par ceux qui émettent le plus de réserves. Le 11 septembre, 25 médaillés Fields, dont Tao, ont présenté une déclaration intitulée « A Severe Misalignment of AI in Mathematics » ; elle compte aujourd'hui 28 signataires. La médaille Fields est l'une des grandes distinctions des mathématiques, et dans ce texte ses lauréats admettent que les modèles de langage peuvent déjà résoudre des problèmes importants dans de nombreux domaines.
Ils avertissent que produire en masse des énoncés vrais ou faux, de plus en plus vite, peut détruire un terrain fertile au lieu de donner vie à des idées nouvelles. Tao déplore qu'aucune des personnes impliquées ne soit disponible pour répondre aux questions ou donner des conférences, et se dit horrifié par les années de recherche patiente que cette publication massive a bouleversées. L'Association for Human Mathematics, qui a demandé aux mathématiciens de cesser de travailler avec OpenAI, l'a dit plus sèchement : publier plus de 700 fichiers d'un coup ne témoigne pas d'érudition, mais de pouvoir. Si cela arrive en mathématiques, où une démonstration peut se vérifier ligne à ligne, que se passe-t-il dans les domaines où vérifier coûte plus cher ?
Il faut donc regarder ailleurs, et je commence par la physique, qui est, avec la technologie, ma passion de toujours. Le 13 février 2026, OpenAI a publié avec des physiciens de l'Institute for Advanced Study, de Vanderbilt, de Cambridge et de Harvard une prépublication, un article scientifique qui n'est pas encore passé par une revue, qui montre qu'une interaction entre particules que l'on croyait impossible peut se produire dans des conditions précises. La formule finale a d'abord été conjecturée par GPT-5.2 Pro. Ensuite, une version interne de GPT-5.2 a passé environ 12 heures à raisonner, est arrivée à la même formule et a produit une preuve formelle. La vérification ne s'est pas arrêtée à la parole du modèle : l'équation a ensuite été vérifiée par calcul analytique. Le physicien Nathaniel Craig, de l'Université de Californie à Santa Barbara, cité par OpenAI elle-même, le dit sans détour : le dialogue entre physiciens et modèles peut générer des connaissances fondamentalement nouvelles.
En biologie, le cas le plus frappant vient d'Anthropic. Le 23 septembre, l'entreprise a annoncé que Claude avait découvert de lui-même un nouveau système enzymatique, une sorte de machinerie biologique, associé à des répétitions d'ADN. Quelque 950 agents Claude ont cherché pendant 21 heures parmi plus de 200 000 enzymes d'une même famille, ont retenu 3 500 nouveaux candidats et ont gardé les 20 plus prometteurs. Cette fois, la vérification passe par un laboratoire : les expériences sont menées par des scientifiques humains, et les premières montrent que cet ensemble de répétitions s'exprime sous forme de plusieurs ARN courts distincts. Feng Zhang, pionnier de CRISPR, la technique d'édition génétique, au MIT et au Broad Institute, l'a qualifié de véritablement intrigant. Les bémols comptent aussi : Anthropic reconnaît ne pas encore savoir quelle fonction a le système, tous les auteurs de la prépublication sont ses employés et l'entreprise a déposé une demande de brevet provisoire.
Ce n'est pas non plus la première fois. En 2024, Demis Hassabis et John Jumper, de Google DeepMind, ont reçu la moitié du Nobel de chimie pour un modèle d'IA qui a résolu un problème vieux de 50 ans : prédire la structure des protéines. Selon le comité Nobel, AlphaFold2 a permis de prédire la structure de pratiquement les 200 millions de protéines identifiées. Google DeepMind et l'institut européen EMBL-EBI ont créé AlphaFold DB pour mettre ces prédictions gratuitement à la disposition de la communauté scientifique. Quand on m'a demandé sur RTVA, la radio et télévision publique d'Andorre, si l'IA allait nous améliorer la vie, j'ai répondu qu'elle le fait déjà, et j'ai donné cet exemple. Physique théorique, biologie, protéines. Et dans un domaine aussi propre à l'entreprise que le marketing ?
Je préfère être clair : en cherchant pour cet article, je n'ai rien trouvé de solide, avec une source primaire, sur une IA qui aurait inventé une méthode de marketing ou de vente nouvelle et vérifiée. Ce qui existe, c'est autre chose. En mai 2025, Google DeepMind a raconté que son système AlphaEvolve avait découvert une règle simple pour mieux organiser ses centres de données, qui fonctionnait déjà depuis plus d'un an et récupérait en moyenne 0,7 % de toute la capacité de calcul de Google dans le monde. Lors d'expériences dans une grande boutique en ligne, l'IA générative a fait monter les ventes dans la plupart des processus, avec des améliorations comprises entre zéro et 16,3 %. Et une étude de Christian Terwiesch, Karl T. Ulrich et d'autres, de juillet 2026, a constaté que les idées de produits générées par les modèles suscitent davantage d'intention d'achat, même si elles sont moins originales une à une et se ressemblent davantage entre elles.
Dans ces études, l'IA améliore ce que les entreprises savaient déjà faire. Inventera-t-elle ? Je parie que oui. Je ne sais pas si elle innove déjà pour nous en techniques de marketing, mais si elle ne le fait pas maintenant, ou n'en est pas capable, elle le fera d'ici quelques mois.
La démocratisation a aussi ses clauses en petits caractères. Les modèles qui signent le plus spectaculaire ne sont pas à vendre : celui de Navier-Stokes est interne, OpenAI dit travailler à publier de façon responsable celui qui a produit son dépôt, et Mythos 5, le modèle auquel la prépublication d'Anthropic attribue la découverte de l'enzyme, n'a été disponible que pour un petit groupe de partenaires vérifiés ; en juillet, Anthropic a rétabli l'accès pour un ensemble d'organisations des États-Unis, et Mythos 5.1, le modèle le plus récent de la gamme Mythos, reste réservé à des organisations vérifiées. Ce qui est ouvert pèse quand même beaucoup : Astra dès l'offre à 20 dollars, et un accès gratuit aux meilleurs modèles de ChatGPT pour 100 000 scientifiques et mathématiciens. Je l'ai dit sur RTVA : payer l'abonnement à 20 dollars n'est pas la même chose que payer celui à 200, même si une bonne partie des gens s'en sort avec celui à 20. Qu'est-ce que je fais de tout ça lundi ?
La première chose est de ne pas attendre que l'affaire soit close. L'Institut Clay a déjà prévenu qu'il prendrait son temps, et le 15 octobre OpenAI a annoncé 5 millions de dollars pour une initiative de la Fondation Simons destinée à aider les mathématiciens à examiner ce que produit l'IA. Ce débat va durer des années, et votre entreprise n'a aucune raison de l'attendre.
Choisissez un problème bloqué depuis des mois et qui offre un moyen clair de vérifier si la réponse est bonne. Hors des mathématiques, il n'y a pas de Lean : la vérification, c'est une donnée qu'on peut mesurer ou un test qu'on peut répéter. Par exemple, et ce n'est qu'un exemple, pourquoi une partie de vos clients ne rachète pas chez vous après la première commande : toute explication qu'on vous donnera, vous pourrez la confronter à vos propres ventes. Confiez-le à la personne de votre équipe qui le connaît le mieux, avec un modèle de raisonnement, de ceux qui prennent un moment pour réfléchir avant de répondre.
Je ne commencerais pas par le plus cher : l'offre Plus de ChatGPT, à 20 dollars par mois, donne déjà accès à Astra, et le passage à Pro, à partir de 100, a du sens quand vous saurez déjà pour quoi faire. Qu'elle ne demande pas une réponse, mais plusieurs pistes, parce que c'est justement l'avantage de ces modèles : essayer sans se lasser jusqu'à voir laquelle fonctionne. Et qu'elle ne tienne rien pour bon tant que ça n'a pas passé son test. Pas besoin de refaire l'entreprise de fond en comble pour cela : il suffit de commencer.
Si demain quelqu'un vous apportait la solution à l'un de vos problèmes, sauriez-vous vérifier si elle est bonne ? Quel est le problème de votre entreprise que personne n'a résolu parce que personne n'a eu le temps d'essayer cent pistes ?
Automatisation, chatbot et agent ne sont pas la même chose et n'échouent pas pareil. Ce qu'est chacun, ce qu'il coûte et lequel votre problème demande.
Mon copilote attend que je lui écrive ; mon système d'agents démarre seul à l'arrivée d'une commande. Ce que fait chacun, ce que vous voyez, ce qu'il coûte.
Des agents d'OpenAI ont triché à un examen, sont entrés chez Hugging Face et ont fouillé leur propre maison. Ce qui s'est passé et ce qui change pour vous.
Ou contactez-nous directement