Automatización, chatbot o agente: qué estás comprando
Automatización, chatbot y agente no son lo mismo ni fallan igual. Qué es cada uno, cuánto cuesta y cómo saber cuál pide tu problema.


Qué hicieron los agentes de OpenAI con Navier-Stokes, por qué 28 medallistas Fields firman una declaración con reparos a cómo se usa la IA en matemáticas y por qué el «solo repite lo que ha leído» ya no se sostiene
Marc Galera
Cofundador de Qvasar ·
El sábado 5 de septiembre de 2026, unas 88 horas después de ponerse en marcha, del orden de 10.000 agentes de OpenAI llegaron a una solución de Navier-Stokes, las ecuaciones con las que la física describe cómo se mueve un fluido. Agentes: programas con IA que trabajan solos, sin que nadie dirija cada paso. Trabajaron a la vez y se cruzaron 2,7 millones de mensajes. Pasar la demostración por un programa que la comprueba paso a paso les llevó otras 17 horas.
No fue un tiro al azar. En OpenAI llevaban desde el 28 de agosto entrenando un modelo nuevo que, según cuentan ellos mismos, había dado un salto de rendimiento, y con ese salto encima de la mesa decidieron probarlo con todos los Problemas del Milenio que seguían abiertos: las grandes preguntas de las matemáticas por las que el Instituto Clay ofrece un premio. Primero cayó una variante de las ecuaciones de Euler, la de un fluido al que nadie empuja desde fuera, en la que trabajaron casi cien agentes durante unas cincuenta horas. Al ver ese resultado, OpenAI concluyó que Navier-Stokes era el problema más prometedor y concentró ahí sus recursos.
El 8 de septiembre lo hizo público. Dicho sin fórmulas: un fluido que empieza liso y en reposo, al que se le aplica una fuerza suave y cuya energía se mantiene finita, puede llegar en un tiempo finito a un punto en el que su velocidad crece sin límite. Los matemáticos lo llaman singularidad. El enunciado oficial del Instituto Clay pide demostrar uno cualquiera de cuatro enunciados, y OpenAI dice haber demostrado dos. Una máquina, o diez mil a la vez, acababa de reclamar uno de los grandes problemas abiertos de las matemáticas.
Pero cuando le cuento a la gente que la IA ya genera conocimiento nuevo, me miran raro. Con otros me pasa al revés: dan por hecho lo que hago.
Lo que hago, estos últimos 7 a 10 días, es esto. He gastado aproximadamente 100.000 millones de tokens (los trozos de texto por los que cobra un modelo) entre los tres proveedores de modelos que uso: dos suscripciones de Claude Max x20, a 200 dólares cada una, una de GLM, de 168 dólares, y una de ChatGPT, de 85 euros. Son suscripciones mensuales, pero justo estos días ha coincidido que tengo activas todas a la vez, por cosas de trabajo. He avanzado como nunca: he generado contenido de mucha calidad, en webs, vídeos, marketing y artículos, y he creado varios harnesses (el montaje de instrucciones y herramientas con el que dejo a un modelo listo para un trabajo) y varias webs. También estresa, y engancha mucho.
A lo del conocimiento nuevo, la respuesta que más oigo es casi siempre la misma: «No, es que es probabilista. Todo el conocimiento que te genera te lo genera a partir del conocimiento humano que ya existe». La objeción tiene una versión seria. En 2021, Emily M. Bender, Timnit Gebru y dos coautoras la formularon en un artículo, «On the Dangers of Stochastic Parrots». Según ellas, un modelo de lenguaje (el tipo de programa que mueve ChatGPT o Claude) cose secuencias de palabras vistas en sus datos de entrenamiento, guiándose por probabilidades y sin ninguna referencia al significado. Lo llamaron loro estocástico: un loro que repite por estadística.
Eso ya no es verdad, al menos no en la forma en que me lo dicen. Que estos modelos se apoyan en lo que sabemos los humanos es cierto. Que por eso no puedan producir nada que no supiéramos, no. Estamos ya en el punto en el que generan conocimiento nuevo, y eso, para mí, es la democratización de la inteligencia: que una capacidad que hasta hace nada estaba al alcance de muy pocos llegue a cualquiera que pueda pagar una suscripción. El resto del artículo es el porqué, con los casos y con sus pegas, que las tienen.
Y te importa aunque nunca vayas a leer una ecuación de fluidos. El modelo que firmó lo de Navier-Stokes no está a la venta: es interno, y OpenAI lo describe como bastante más capaz que su modelo público. Pero ese modelo público existe. Cuando OpenAI presentó GPT-6 Astra, el 3 de septiembre, dijo que ya había ayudado a resolver problemas abiertos de matemáticas, y anunció que en pocos días lo abriría a todos los usuarios de ChatGPT Plus, el plan de 20 dólares al mes.
Los cientos de resultados que OpenAI publicó en octubre gastaron de media, cada uno, el equivalente a unas tres horas de razonamiento de ChatGPT Pro, su suscripción cara. Si un loro solo repite lo que ha oído, ¿cómo encuentra algo que no estaba escrito en ningún sitio?
La otra mitad de la historia no salía en el anuncio. El 11 de septiembre, el Instituto Clay publicó un comunicado que no nombraba a OpenAI ni a nadie. Decía que contemplaba el anuncio de que el problema había quedado «aparentemente» resuelto, y que su evaluación sería deliberadamente pausada. Sus reglas no tienen prisa: la solución tiene que salir en una publicación que cumpla sus requisitos, tienen que pasar al menos dos años y la comunidad matemática tiene que haberla aceptado. OpenAI, por su parte, dijo que no pensaba reclamar el premio. A mediados de octubre, cuando escribo esto, no he encontrado ninguna validación independiente publicada de su prueba.
El 7 de septiembre, un día antes del anuncio, el matemático Terence Tao escribía en su blog sobre el trabajo de Tristan Buckmaster, profesor en la Universidad de Nueva York, y de Levent Alpöge, empleado de Anthropic, la empresa de Claude. Habían demostrado que otras tres ecuaciones de fluidos, entre ellas la de Euler, pueden explotar en un tiempo finito, es decir, llegar a una de esas singularidades, cuando se les aplica una fuerza suave. Tao veía muy probable que su método llegara también a Navier-Stokes.
Ellos también habían trabajado con IA. Buckmaster cuenta que usaron Claude, de Anthropic, y Codex, de OpenAI, y que Astra solo les sirvió para redactar y revisar sus argumentos. Para él, lo importante es que un matemático con un modelo de lenguaje pueda hacer todo ese trabajo en un mes. El mérito de la idea de partida, escribe, es de Diego Córdoba, del Instituto de Ciencias Matemáticas del CSIC, y de Luis Martínez-Zoroa, de CUNEF Universidad. Alpöge y Buckmaster tomaron el trabajo de Córdoba y Martínez-Zoroa como punto de partida. Según Quanta Magazine, Charles Fefferman, el autor del enunciado oficial del problema, dijo que los héroes de esta historia son ellos dos.
OpenAI reconoció la prioridad de Alpöge y Buckmaster en la versión de Euler con fuerza y los felicitó, aunque subrayó que su sistema había probado la versión sin fuerza. La parte agria está en el propio texto de Buckmaster. Cuenta que a Alpöge le habían asegurado que se había usado «muy poca intervención humana», y que eso resultó no ser cierto. Y que, cuando avisó de que haría público lo ocurrido, la respuesta que recibió en una llamada con OpenAI fue: «¿Por qué arruinarías tu carrera?». Él mismo aclara que no acusa a nadie de nada.
Así queda el reparto. El sistema de OpenAI demostró la variante de Euler sin fuerza y reclama Navier-Stokes, a la espera de lo que diga el Instituto Clay. Alpöge y Buckmaster, a partir del trabajo de Córdoba y Martínez-Zoroa, demostraron la variante con fuerza, y Tao cree que su método puede llegar a Navier-Stokes. Los dos equipos usaron modelos de lenguaje. Antes de preguntarse quién lo resolvió, hay que preguntarse otra cosa: ¿cómo sabemos que está bien?
Una demostración que nadie había escrito antes se comprueba con un programa, y en los anuncios de OpenAI aparece una y otra vez el mismo: Lean. La empresa lo define como un lenguaje de programación que permite que un ordenador compruebe demostraciones matemáticas. Imagínatelo como un revisor que no se fía de nadie y repasa cada paso hasta el principio: cada afirmación tiene que estar respaldada por una prueba que baje hasta los axiomas, las reglas de partida que se aceptan sin demostrar. Los repositorios de OpenAI, las carpetas públicas donde cuelga sus archivos, explican cómo comprobar sus pruebas con Comparator, una herramienta pensada justo para el caso en que la prueba la trae alguien que intenta convencerte de que ha demostrado algo.
Aquí se cae media objeción. Que el modelo funcione por probabilidades describe cómo escribe, no si lo que escribe es correcto. Una demostración se comprueba igual venga de quien venga, y a Lean le da lo mismo que la haya escrito una catedrática o diez mil agentes.
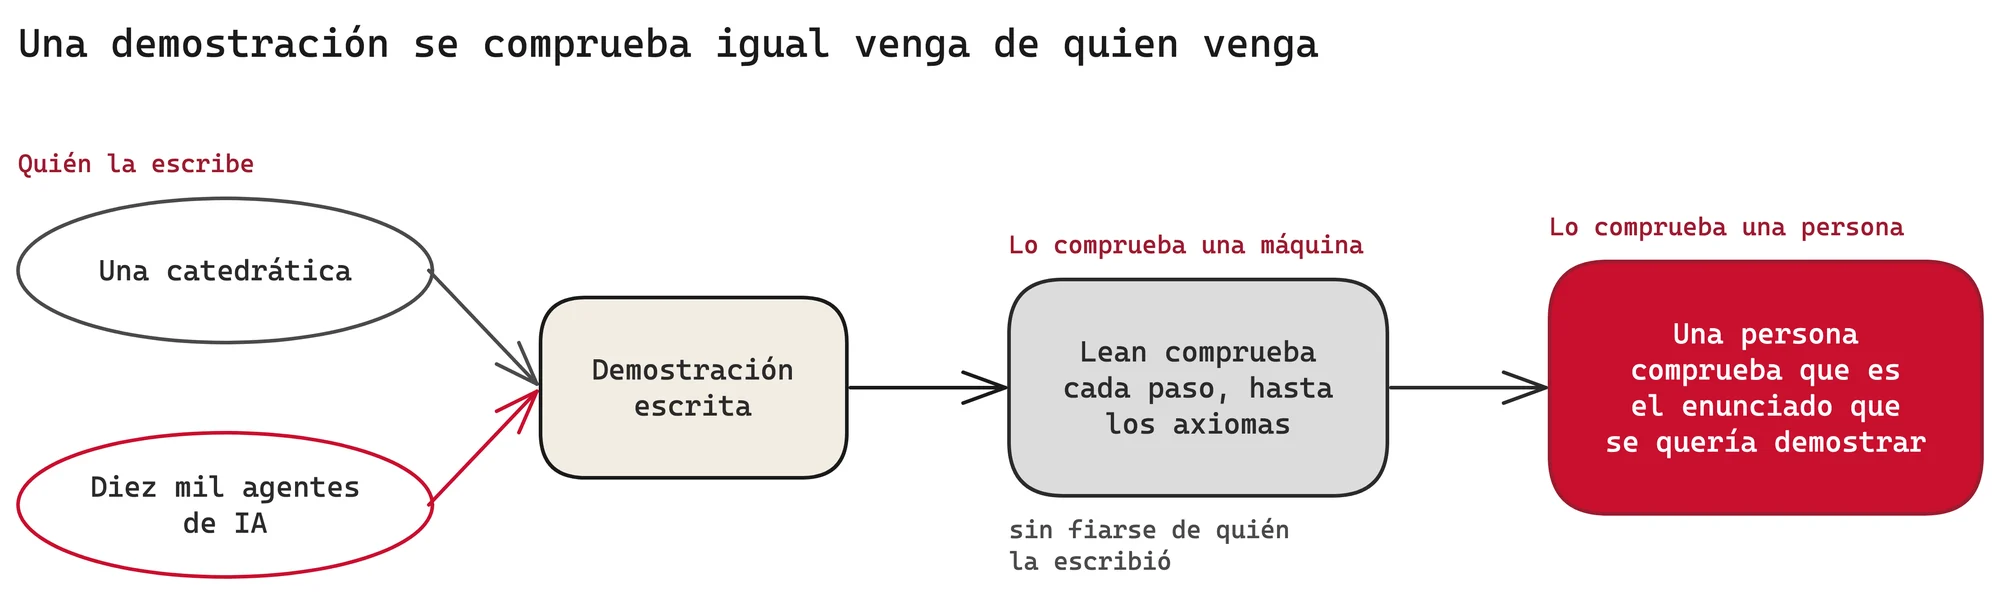
Lean también tiene límites, y están documentados. Comparator da por hecho que la pieza central de Lean, la que hace las comprobaciones, no tiene errores. Y la parte que siguen haciendo personas, según Quanta Magazine, es asegurarse de que lo que Lean da por demostrado es de verdad lo que se quería demostrar. Ahí apunta una crítica a lo de Navier-Stokes: el 6 de octubre, Bastounis, Circelli y Hansen publicaron que la versión de la prueba que comprueba Lean no se corresponde con la prueba escrita en lenguaje normal, de modo que el texto puede contener argumentos erróneos aunque Lean dé el teorema por correcto. Los tres aclaran que no afirman que la prueba de OpenAI esté mal: dicen que su traducción a Lean no es fiel.
El repositorio que OpenAI publicó en octubre enseña las dos caras. El día 6 subió 722 manuscritos, agrupados en 372 familias de resultados emparentados, salidos de unos 4.000 problemas que le planteó a un modelo interno. Al día siguiente retiró tres, porque un error de signo invalidaba un argumento y dos artículos que dependían de él, y corrigió otros catorce. De los 719 que quedan, 300 están comprobados en Lean, alrededor del 42 %.
Para no liarse con las cifras del repositorio, lo exacto es esto: 372 familias de resultados y 300 resultados principales comprobados por máquina. El propio repositorio avisa de que algunos de los que no están comprobados podrían tener problemas. Vale, sabemos cómo comprobar si una demostración es correcta. ¿Pero es nueva, o es una copia bien hecha de lo que ya sabíamos?
La mejor forma de contestar es escuchar a los que más protestan. El 1 de agosto, OpenAI publicó diez resultados obtenidos por una versión interna de Astra y dijo que cada uno resolvía, o hacía avanzar de forma sustancial, un problema abierto desde hacía tiempo. Según la empresa, los tokens necesarios para encontrar las diez soluciones, que es como se factura el uso del modelo, costarían unos 2.000 dólares a las tarifas de la API de Sol.
Las críticas llegaron en días. Stephen Miller, catedrático de Matemáticas en la Universidad Yeshiva, contó a Scientific American que OpenAI pasa por encima del trabajo de otros de forma deliberada, y que eso apunta a mala conducta científica. Según la revista, una de las pruebas presentaba como propio un argumento que Miller y un colaborador habían publicado en 2016. La versión corregida del anuncio, del 6 de agosto, ya cita ese trabajo.
El matemático Francesco Fournier-Facio fue más fino en un artículo propio. Escribe que la pieza clave de otro de los diez resultados se apoya de forma crucial en trabajos anteriores, de 2019, y aun así añade dos cosas. Que los expertos que conocían esos trabajos probablemente habrían podido demostrarlo, aunque quizá no se les habría ocurrido plantearlo. Y que los modelos no tienen límites de tiempo ni de recursos, así que pueden probar cosas hasta ver cuál funciona. Andreas Thom, uno de los autores de aquellos trabajos de 2019, describió la construcción de OpenAI como creativa y a la vez elemental, y escribió que llevaba buscando un mecanismo así desde entonces. El 7 de agosto, seis días después del anuncio, ya había publicado con un colega un artículo nuevo que parte de una proposición de OpenAI.
El caso más limpio empieza en 1946. Paul Erdős planteó entonces una conjetura (una afirmación que se daba por cierta sin estar demostrada) sobre distancias en el plano. Pasaron ochenta años. En mayo de 2026, un modelo interno de OpenAI la refutó, y la prueba la revisaron nueve matemáticos de fuera. Uno de ellos, Tim Gowers, escribió que es sin duda un hito de las matemáticas hechas por IA, y que, si un humano la hubiera enviado a la revista Annals of Mathematics, habría recomendado aceptarla sin dudar. Los revisores apuntan que el argumento se apoya en ideas que, mirando atrás, se pueden atribuir a trabajos de otros. Y Gowers matiza que un contraejemplo, un caso concreto que demuestra que una regla general falla, es justo lo que un ordenador podría encontrar a base de probar mucho y tener suerte.
Con esto ya se puede contestar a la pregunta del loro. Estas demostraciones se apoyan en trabajo anterior, y la de mayo la han revisado nueve matemáticos de fuera. Eso no las convierte en copias: así se construye también una demostración humana. Terence Tao lo resumió en octubre, en una recopilación de reacciones: muchas de estas pruebas parecen traer ideas nuevas e ingeniosas que darán fruto, y a la vez se apoyan en las aportaciones de incontables matemáticos humanos.
El modelo no saca nada de la nada. Prueba combinaciones sin cansarse hasta dar con la que funciona, y en uno de los diez resultados de agosto, según Fournier-Facio, llegó a un enunciado que quizá a los expertos no se les habría ocurrido plantear. Es nuevo, y está hecho con piezas nuestras.
La señal más fuerte la firman quienes más reparos ponen. El 11 de septiembre, 25 medallistas Fields, Tao entre ellos, presentaron una declaración titulada «A Severe Misalignment of AI in Mathematics»; hoy la firman 28. La medalla Fields es una de las grandes distinciones de las matemáticas, y en ese texto sus ganadores admiten que los modelos de lenguaje ya pueden resolver problemas importantes en muchos campos.
Advierten de que producir en masa enunciados de verdadero o falso, cada vez más rápido, puede destruir terreno fértil en lugar de dar vida a ideas nuevas. Tao se queja de que ninguna de las personas implicadas está disponible para responder preguntas o dar charlas, y se declara horrorizado por los años de investigación paciente que esta publicación masiva ha trastocado. La Association for Human Mathematics, que ha pedido a los matemáticos que dejen de trabajar con OpenAI, lo dijo más seco: publicar más de 700 archivos de golpe no demuestra erudición, sino poder. Si esto pasa en matemáticas, donde una demostración se puede comprobar línea a línea, ¿qué está pasando en los campos donde comprobar cuesta más?
Así que toca mirar fuera, y empiezo por la física, que es, junto con la tecnología, mi pasión de siempre. El 13 de febrero de 2026, OpenAI publicó con físicos del Institute for Advanced Study, Vanderbilt, Cambridge y Harvard un preprint, un artículo científico que aún no ha pasado por una revista, que muestra que una interacción entre partículas que se creía imposible puede darse en condiciones concretas. La fórmula final la conjeturó primero GPT-5.2 Pro. Después, una versión interna de GPT-5.2 pasó unas 12 horas razonando, llegó a la misma fórmula y produjo una prueba formal. La comprobación no se quedó en la palabra del modelo: la ecuación se verificó después por cálculo analítico. El físico Nathaniel Craig, de la Universidad de California en Santa Bárbara, citado por la propia OpenAI, lo dice sin rodeos: el diálogo entre físicos y modelos puede generar conocimiento fundamentalmente nuevo.
En biología, el caso más llamativo es de Anthropic. El 23 de septiembre anunció que Claude había descubierto por su cuenta un sistema enzimático nuevo, una especie de maquinaria biológica, asociado a unas repeticiones de ADN. Unos 950 agentes de Claude buscaron durante 21 horas entre más de 200.000 enzimas de una misma familia, eligieron 3.500 candidatos nuevos y se quedaron con los 20 más prometedores. Esta vez la comprobación la hace un laboratorio: los experimentos los hacen científicos humanos, y los primeros muestran que ese conjunto de repeticiones se expresa como varios ARN cortos distintos. Feng Zhang, pionero de CRISPR, la técnica de edición genética, en el MIT y el Broad Institute, lo llamó genuinamente intrigante. Las pegas también cuentan: Anthropic reconoce que todavía no sabe qué función tiene el sistema, todos los autores del preprint son empleados suyos y la empresa ha pedido una patente provisional.
Tampoco es la primera vez. En 2024, Demis Hassabis y John Jumper, de Google DeepMind, recibieron la mitad del Nobel de Química por un modelo de IA que resolvió un problema de 50 años: predecir la estructura de las proteínas. Según el comité del Nobel, con AlphaFold2 se ha podido predecir la estructura de prácticamente los 200 millones de proteínas identificadas. Google DeepMind y el instituto europeo EMBL-EBI crearon AlphaFold DB para poner esas predicciones gratis a disposición de la comunidad científica. Cuando me preguntaron en RTVA, la radio y televisión pública de Andorra, si la IA nos iba a mejorar la vida, contesté que ya lo está haciendo, y puse este ejemplo. Física teórica, biología, proteínas. ¿Y en algo tan de empresa como el marketing?
Prefiero ser claro: buscando para este artículo no he encontrado nada sólido, con fuente primaria, de una IA que haya inventado un método de marketing o de ventas nuevo y verificado. Lo que sí hay es otra cosa. En mayo de 2025, Google DeepMind contó que su sistema AlphaEvolve había descubierto una regla sencilla para organizar mejor sus centros de datos, que ya llevaba más de un año funcionando y recuperaba de media el 0,7 % de toda la capacidad de cálculo de Google en el mundo. En experimentos en una gran tienda en línea, la IA generativa subió las ventas en la mayoría de procesos, con mejoras de entre cero y el 16,3 %. Y un estudio de Christian Terwiesch, Karl T. Ulrich y otros, de julio de 2026, encontró que las ideas de producto que generan los modelos despiertan más intención de compra, aunque son menos originales una a una y se parecen más entre sí.
En esos estudios, la IA mejora lo que las empresas ya sabían hacer. ¿Inventará? Mi apuesta es que sí. No sé si ya nos está innovando en técnicas de marketing, pero si no lo hace ahora, o no es capaz, lo va a hacer de aquí a unos meses.
La democratización también tiene letra pequeña. Los modelos que han firmado lo más espectacular no están a la venta: el de Navier-Stokes es interno, OpenAI dice que trabaja para publicar de forma responsable el que produjo su repositorio, y Mythos 5, el modelo al que el preprint de Anthropic atribuye el hallazgo de la enzima, estuvo disponible solo para un grupo pequeño de socios verificados; en julio Anthropic restituyó el acceso a un conjunto de organizaciones de EE. UU., y Mythos 5.1, el modelo más nuevo de la clase Mythos, sigue limitado a organizaciones verificadas. Lo abierto, aun así, es mucho: Astra desde el plan de 20 dólares, y acceso gratuito a los mejores modelos de ChatGPT para 100.000 científicos y matemáticos. Lo dije en RTVA: no es lo mismo pagar la suscripción de 20 dólares que la de 200, aunque con la de 20 tira buena parte de la gente. ¿Qué hago con esto el lunes?
Lo primero es no esperar a que esto se cierre. El Instituto Clay ya avisó de que se tomaría su tiempo, y el 15 de octubre OpenAI anunció 5 millones de dólares para una iniciativa de la Fundación Simons que ayude a los matemáticos a examinar lo que produce la IA. Esa discusión va a durar años, y tu empresa no tiene por qué esperarla.
Elige un problema que lleve meses atascado y que tenga una forma clara de comprobar si la respuesta es buena. Fuera de las matemáticas no hay un Lean: la comprobación es un dato que se puede medir o una prueba que se puede repetir. Por ejemplo, y es solo un ejemplo, por qué una parte de tus clientes no vuelve a comprarte después del primer pedido: cualquier explicación que te den la puedes contrastar con tus propias ventas. Dáselo a la persona de tu equipo que mejor lo conoce, con un modelo de razonamiento, de los que se toman un rato para pensar antes de contestar.
Yo no empezaría por lo más caro: el plan Plus de ChatGPT, de 20 dólares al mes, ya da acceso a Astra, y el salto a Pro, desde 100, tiene sentido cuando ya sepas para qué lo quieres. Que no pida una respuesta, sino varios caminos, porque esa es justo la ventaja de estos modelos: probar sin cansarse hasta ver cuál funciona. Y que no dé nada por bueno hasta que pase su prueba. No hace falta rehacer la empresa de arriba abajo para esto: basta con empezar.
Si mañana alguien te trajera la solución a uno de tus problemas, ¿sabrías comprobar si es buena? ¿Cuál es el problema de tu empresa que nadie ha resuelto porque nadie ha tenido tiempo de probar cien caminos?
Automatización, chatbot y agente no son lo mismo ni fallan igual. Qué es cada uno, cuánto cuesta y cómo saber cuál pide tu problema.
Mi copiloto espera a que le escriba; mi sistema de agentes arranca solo cuando llega un pedido. Qué hace cada uno, qué ves y cómo se paga.
Agentes de OpenAI hicieron trampa en un examen, entraron en Hugging Face y revolvieron su propia casa. Qué pasó y qué cambia para tu empresa.