Automatització, xatbot o agent: què estàs comprant
Automatització, xatbot i agent no són el mateix ni fallen igual. Què és cadascun, quant costa i com saber quin demana el teu problema.


Què van fer els agents d'OpenAI amb Navier-Stokes, per què 28 medallistes Fields signen una declaració amb objeccions a com es fa servir la IA en matemàtiques i per què el «només repeteix el que ha llegit» ja no s'aguanta
Marc Galera
Cofundador de Qvasar ·
El dissabte 5 de setembre de 2026, unes 88 hores després de posar-se en marxa, de l'ordre de 10.000 agents d'OpenAI van arribar a una solució de Navier-Stokes, les equacions amb què la física descriu com es mou un fluid. Agents: programes amb IA que treballen sols, sense que ningú en dirigeixi cada pas. Van treballar alhora i es van creuar 2,7 milions de missatges. Passar la demostració per un programa que la comprova pas a pas els va costar 17 hores més.
No va ser un tret a l'atzar. A OpenAI entrenaven des del 28 d'agost un model nou que, segons expliquen ells mateixos, havia fet un salt de rendiment, i amb aquest salt sobre la taula van decidir provar-lo amb tots els Problemes del Mil·lenni que encara eren oberts: les grans preguntes de les matemàtiques per les quals l'Institut Clay ofereix un premi. Primer va caure una variant de les equacions d'Euler, la d'un fluid que ningú no empeny des de fora, en què van treballar gairebé cent agents durant unes cinquanta hores. En veure aquest resultat, OpenAI va concloure que Navier-Stokes era el problema més prometedor i hi va concentrar els recursos.
El 8 de setembre ho va fer públic. Dit sense fórmules: un fluid que comença llis i en repòs, al qual s'aplica una força suau i l'energia del qual es manté finita, pot arribar en un temps finit a un punt en què la seva velocitat creix sense límit. Els matemàtics en diuen singularitat. L'enunciat oficial de l'Institut Clay demana demostrar qualsevol de quatre enunciats, i OpenAI diu que n'ha demostrat dos. Una màquina, o deu mil alhora, acabava de reclamar un dels grans problemes oberts de les matemàtiques.
Però quan explico a la gent que la IA ja genera coneixement nou, em miren estrany. Amb d'altres em passa al revés: donen per fet el que faig.
El que faig, aquests últims 7 a 10 dies, és això. He gastat aproximadament 100.000 milions de tokens (els trossos de text pels quals cobra un model) entre els tres proveïdors de models que faig servir: dues subscripcions de Claude Max x20, a 200 dòlars cadascuna, una de GLM, de 168 dòlars, i una de ChatGPT, de 85 euros. Són subscripcions mensuals, però justament aquests dies ha coincidit que les tinc totes actives alhora, per coses de feina. He avançat com mai: he generat contingut de molta qualitat, en webs, vídeos, màrqueting i articles, i he creat diversos harnesses (el muntatge d'instruccions i eines amb què deixo un model a punt per a una feina) i diverses webs. També estressa, i enganxa molt.
Quan parlo del coneixement nou, la resposta que més sento és gairebé sempre la mateixa: «No, és que és probabilista. Tot el coneixement que et genera te'l genera a partir del coneixement humà que ja existeix». L'objecció té una versió seriosa. El 2021, Emily M. Bender, Timnit Gebru i dues coautores la van formular en un article, «On the Dangers of Stochastic Parrots». Segons elles, un model de llenguatge (el tipus de programa que mou ChatGPT o Claude) cus seqüències de paraules vistes a les seves dades d'entrenament, guiant-se per probabilitats i sense cap referència al significat. En van dir lloro estocàstic: un lloro que repeteix per estadística.
Això ja no és veritat, almenys no en la forma en què m'ho diuen. Que aquests models es basen en el que sabem els humans és cert. Que per això no puguin produir res que no sabéssim, no. Ja som al punt en què generen coneixement nou, i això, per a mi, és la democratització de la intel·ligència: que una capacitat que fins fa no res era a l'abast de molt pocs arribi a qualsevol que pugui pagar una subscripció. La resta de l'article és el perquè, amb els casos i amb els seus inconvenients, que en tenen.
I t'importa encara que no hagis de llegir mai una equació de fluids. El model que va signar allò de Navier-Stokes no està a la venda: és intern, i OpenAI el descriu com a força més capaç que el seu model públic. Però aquest model públic existeix. Quan OpenAI va presentar GPT-6 Astra, el 3 de setembre, va dir que ja havia ajudat a resoldre problemes oberts de matemàtiques, i va anunciar que en pocs dies l'obriria a tots els usuaris de ChatGPT Plus, el pla de 20 dòlars al mes.
Els centenars de resultats que OpenAI va publicar a l'octubre van gastar de mitjana, cadascun, l'equivalent a unes tres hores de raonament de ChatGPT Pro, la seva subscripció cara. Si un lloro només repeteix el que ha sentit, com troba una cosa que no era escrita enlloc?
L'altra meitat de la història no sortia a l'anunci. L'11 de setembre, l'Institut Clay va publicar un comunicat que no anomenava OpenAI ni ningú. Deia que prenia nota de l'anunci segons el qual el problema havia quedat «aparentment» resolt, i que la seva avaluació seria deliberadament pausada. Les seves regles no tenen pressa: la solució ha de sortir en una publicació que compleixi els seus requisits, han de passar com a mínim dos anys i la comunitat matemàtica l'ha d'haver acceptada. OpenAI, per la seva banda, va dir que no pensava reclamar el premi. A mitjan octubre, quan escric això, no he trobat cap validació independent publicada de la seva prova.
El 7 de setembre, un dia abans de l'anunci, el matemàtic Terence Tao escrivia al seu blog sobre la feina de Tristan Buckmaster, professor a la Universitat de Nova York, i de Levent Alpöge, treballador d'Anthropic, l'empresa de Claude. Havien demostrat que tres altres equacions de fluids, entre les quals la d'Euler, poden explotar en un temps finit, és a dir, arribar a una d'aquestes singularitats, quan se'ls aplica una força suau. Tao veia molt probable que el seu mètode arribés també a Navier-Stokes.
Ells també havien treballat amb IA. Buckmaster explica que van fer servir Claude, d'Anthropic, i Codex, d'OpenAI, i que Astra només els va servir per redactar i revisar els seus arguments. Per a ell, l'important és que un matemàtic amb un model de llenguatge pugui fer tota aquesta feina en un mes. El mèrit de la idea de partida, escriu, és de Diego Córdoba, de l'Instituto de Ciencias Matemáticas del CSIC, i de Luis Martínez-Zoroa, de CUNEF Universidad. Alpöge i Buckmaster van prendre la feina de Córdoba i Martínez-Zoroa com a punt de partida. Segons Quanta Magazine, Charles Fefferman, l'autor de l'enunciat oficial del problema, va dir que els herois d'aquesta història són ells dos.
OpenAI va reconèixer la prioritat d'Alpöge i Buckmaster en la versió d'Euler amb força i els va felicitar, tot i que va subratllar que el seu sistema havia demostrat la versió sense força. La part agra és al mateix text de Buckmaster. Explica que a Alpöge li havien assegurat que s'havia fet servir «molt poca intervenció humana», i que això va resultar no ser cert. I que, quan va avisar que faria públic el que havia passat, la resposta que va rebre en una trucada amb OpenAI va ser: «Per què arruïnaries la teva carrera?». Ell mateix aclareix que no acusa ningú de res.
Així queda el repartiment. El sistema d'OpenAI va demostrar la variant d'Euler sense força i reclama Navier-Stokes, a l'espera del que digui l'Institut Clay. Alpöge i Buckmaster, a partir de la feina de Córdoba i Martínez-Zoroa, van demostrar la variant amb força, i Tao creu que el seu mètode pot arribar a Navier-Stokes. Els dos equips van fer servir models de llenguatge. Abans de preguntar-se qui ho va resoldre, cal preguntar-se una altra cosa: com sabem que està bé?
Una demostració que ningú no havia escrit abans es comprova amb un programa, i als anuncis d'OpenAI hi apareix una vegada i una altra el mateix: Lean. L'empresa el defineix com un llenguatge de programació que permet que un ordinador comprovi demostracions matemàtiques. Imagina-te'l com un revisor que no es refia de ningú i repassa cada pas fins al principi: cada afirmació ha d'estar avalada per una prova que baixi fins als axiomes, les regles de partida que s'accepten sense demostrar. Els repositoris d'OpenAI, les carpetes públiques on penja els seus fitxers, expliquen com comprovar-ne les proves amb Comparator, una eina pensada justament per al cas en què la prova la porta algú que intenta convèncer-te que ha demostrat alguna cosa.
Aquí cau mitja objecció. Que el model funcioni per probabilitats descriu com escriu, no si el que escriu és correcte. Una demostració es comprova igual vingui d'on vingui, i a Lean li és igual que l'hagi escrita una catedràtica o deu mil agents.
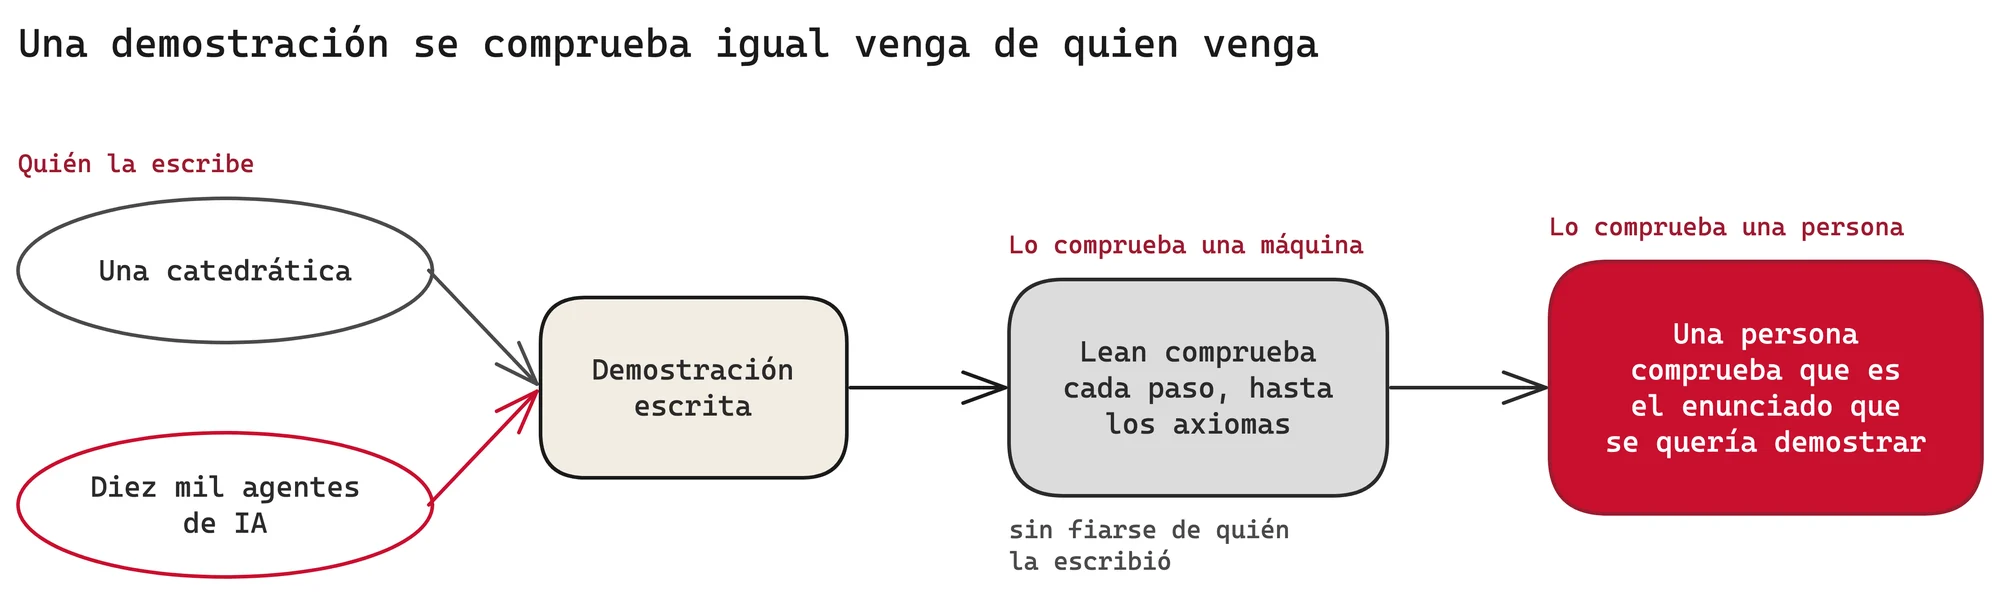
Lean també té límits, i estan documentats. Comparator dona per fet que la peça central de Lean, la que fa les comprovacions, no té errors. I la part que continuen fent persones, segons Quanta Magazine, és assegurar-se que el que Lean dona per demostrat és de veritat el que es volia demostrar. Aquí apunta una crítica al cas de Navier-Stokes: el 6 d'octubre, Bastounis, Circelli i Hansen van publicar que la versió de la prova que comprova Lean no es correspon amb la prova escrita en llenguatge normal, de manera que el text pot contenir arguments erronis encara que Lean doni el teorema per correcte. Tots tres aclareixen que no afirmen que la prova d'OpenAI estigui malament: diuen que la seva traducció a Lean no és fidel.
El repositori que OpenAI va publicar a l'octubre ensenya les dues cares. El dia 6 hi va pujar 722 manuscrits, agrupats en 372 famílies de resultats emparentats, sortits d'uns 4.000 problemes que va plantejar a un model intern. L'endemà en va retirar tres, perquè un error de signe invalidava un argument i dos articles que en depenien, i en va corregir catorze més. Dels 719 que queden, 300 estan comprovats en Lean, al voltant del 42 %.
Per no embolicar-se amb les xifres del repositori, l'exacte és això: 372 famílies de resultats i 300 resultats principals comprovats per màquina. El mateix repositori avisa que alguns dels que no estan comprovats podrien tenir problemes. D'acord, sabem com comprovar si una demostració és correcta. Però és nova, o és una còpia ben feta del que ja sabíem?
La millor manera de respondre és escoltar els qui més protesten. L'1 d'agost, OpenAI va publicar deu resultats obtinguts per una versió interna d'Astra i va dir que cadascun resolia, o feia avançar de manera substancial, un problema obert des de feia temps. Segons l'empresa, els tokens necessaris per trobar les deu solucions, que és com es factura l'ús del model, costarien uns 2.000 dòlars a les tarifes de l'API de Sol.
Les crítiques van arribar en qüestió de dies. Stephen Miller, catedràtic de Matemàtiques a la Universitat Yeshiva, va explicar a Scientific American que OpenAI passa per sobre de la feina d'altres de manera deliberada, i que això apunta a mala conducta científica. Segons la revista, una de les proves presentava com a propi un argument que Miller i un col·laborador havien publicat el 2016. La versió corregida de l'anunci, del 6 d'agost, ja cita aquella feina.
El matemàtic Francesco Fournier-Facio va filar més prim en un article propi. Escriu que la peça clau d'un altre dels deu resultats es basa de manera crucial en treballs anteriors, de 2019, i tot i així hi afegeix dues coses. Que els experts que coneixien aquells treballs probablement l'haurien pogut demostrar, tot i que potser no se'ls hauria acudit plantejar-ho. I que els models no tenen límits de temps ni de recursos, així que poden provar coses fins a veure quina funciona. Andreas Thom, un dels autors d'aquells treballs de 2019, va descriure la construcció d'OpenAI com a creativa i alhora elemental, i va escriure que buscava un mecanisme així des de llavors. El 7 d'agost, sis dies després de l'anunci, ja havia publicat amb un col·lega un article nou que parteix d'una proposició d'OpenAI.
El cas més net comença el 1946. Paul Erdős va plantejar llavors una conjectura (una afirmació que es donava per certa sense estar demostrada) sobre distàncies en el pla. Van passar vuitanta anys. El maig de 2026, un model intern d'OpenAI la va refutar, i la prova la van revisar nou matemàtics de fora. Un d'ells, Tim Gowers, va escriure que és sens dubte una fita de les matemàtiques fetes per IA, i que, si un humà l'hagués enviat a la revista Annals of Mathematics, hauria recomanat acceptar-la sense dubtar. Els revisors apunten que l'argument es basa en idees que, mirant enrere, es poden atribuir a treballs d'altres. I Gowers matisa que un contraexemple, un cas concret que demostra que una regla general falla, és justament el que un ordinador podria trobar a força de provar molt i tenir sort.
Amb això ja es pot respondre la pregunta del lloro. Aquestes demostracions es basen en feina anterior, i la de maig l'han revisada nou matemàtics de fora. Això no les converteix en còpies: també es construeix així una demostració humana. Terence Tao ho va resumir a l'octubre, en un recull de reaccions: moltes d'aquestes proves semblen portar idees noves i enginyoses que donaran fruit, i alhora es basen en les aportacions d'incomptables matemàtics humans.
El model no treu res del no-res. Prova combinacions sense cansar-se fins a trobar la que funciona, i en un dels deu resultats d'agost, segons Fournier-Facio, va arribar a un enunciat que potser als experts no se'ls hauria acudit plantejar. És nou, i està fet amb peces nostres.
El senyal més fort el signen els qui hi posen més objeccions. L'11 de setembre, 25 medallistes Fields, Tao entre ells, van presentar una declaració titulada «A Severe Misalignment of AI in Mathematics»; avui la signen 28. La medalla Fields és una de les grans distincions de les matemàtiques, i en aquest text els seus guanyadors admeten que els models de llenguatge ja poden resoldre problemes importants en molts camps.
Adverteixen que produir en massa enunciats de vertader o fals, cada vegada més de pressa, pot destruir terreny fèrtil en lloc de donar vida a idees noves. Tao es queixa que cap de les persones implicades no està disponible per respondre preguntes o fer xerrades, i es declara horroritzat pels anys de recerca pacient que aquesta publicació massiva ha capgirat. L'Association for Human Mathematics, que ha demanat als matemàtics que deixin de treballar amb OpenAI, ho va dir més sec: publicar més de 700 fitxers de cop no demostra erudició, sinó poder. Si això passa en matemàtiques, on una demostració es pot comprovar línia a línia, què passa en els camps on comprovar costa més?
Així que toca mirar fora, i començo per la física, que és, juntament amb la tecnologia, la meva passió de sempre. El 13 de febrer de 2026, OpenAI va publicar amb físics de l'Institute for Advanced Study, Vanderbilt, Cambridge i Harvard un preprint, un article científic que encara no ha passat per una revista, que mostra que una interacció entre partícules que es creia impossible es pot donar en condicions concretes. La fórmula final la va conjecturar primer GPT-5.2 Pro. Després, una versió interna de GPT-5.2 va passar unes 12 hores raonant, va arribar a la mateixa fórmula i va produir una prova formal. La comprovació no es va quedar en la paraula del model: l'equació es va verificar després per càlcul analític. El físic Nathaniel Craig, de la Universitat de Califòrnia a Santa Barbara, citat per la mateixa OpenAI, ho diu sense embuts: el diàleg entre físics i models pot generar coneixement fonamentalment nou.
En biologia, el cas més cridaner és d'Anthropic. El 23 de setembre va anunciar que Claude havia descobert pel seu compte un sistema enzimàtic nou, una mena de maquinària biològica, associat a unes repeticions d'ADN. Uns 950 agents de Claude van buscar durant 21 hores entre més de 200.000 enzims d'una mateixa família, en van triar 3.500 candidats nous i es van quedar amb els 20 més prometedors. Aquesta vegada la comprovació la fa un laboratori: els experiments els fan científics humans, i els primers mostren que aquest conjunt de repeticions s'expressa com diversos ARN curts diferents. Feng Zhang, pioner de CRISPR, la tècnica d'edició genètica, al MIT i al Broad Institute, ho va qualificar de genuïnament intrigant. Els inconvenients també compten: Anthropic reconeix que encara no sap quina funció té el sistema, tots els autors del preprint són treballadors seus i l'empresa ha demanat una patent provisional.
Tampoc no és la primera vegada. El 2024, Demis Hassabis i John Jumper, de Google DeepMind, van rebre la meitat del Nobel de Química per un model d'IA que va resoldre un problema de 50 anys: predir l'estructura de les proteïnes. Segons el comitè del Nobel, amb AlphaFold2 s'ha pogut predir l'estructura de pràcticament els 200 milions de proteïnes identificades. Google DeepMind i l'institut europeu EMBL-EBI van crear AlphaFold DB per posar aquestes prediccions gratuïtament a disposició de la comunitat científica. Quan em van preguntar a RTVA, la ràdio i televisió pública d'Andorra, si la IA ens milloraria la vida, vaig respondre que ja ho està fent, i vaig posar aquest exemple. Física teòrica, biologia, proteïnes. I en una cosa tan d'empresa com el màrqueting?
Prefereixo ser clar: buscant per a aquest article no he trobat res sòlid, amb font primària, d'una IA que hagi inventat un mètode de màrqueting o de vendes nou i verificat. El que sí que hi ha és una altra cosa. El maig de 2025, Google DeepMind va explicar que el seu sistema AlphaEvolve havia descobert una regla senzilla per organitzar millor els seus centres de dades, que ja feia més d'un any que funcionava i recuperava de mitjana el 0,7 % de tota la capacitat de càlcul de Google al món. En experiments en una gran botiga en línia, la IA generativa va fer pujar les vendes en la majoria de processos, amb millores d'entre zero i el 16,3 %. I un estudi de Christian Terwiesch, Karl T. Ulrich i altres, de juliol de 2026, va trobar que les idees de producte que generen els models desperten més intenció de compra, tot i que són menys originals una per una i s'assemblen més entre elles.
En aquests estudis, la IA millora el que les empreses ja sabien fer. Inventarà? La meva aposta és que sí. No sé si ja ens està innovant en tècniques de màrqueting, però si no ho fa ara, o no n'és capaç, ho farà d'aquí a uns mesos.
La democratització també té lletra petita. Els models que han signat el més espectacular no estan a la venda: el de Navier-Stokes és intern, OpenAI diu que treballa per publicar de manera responsable el que va produir el seu repositori, i Mythos 5, el model a què el preprint d'Anthropic atribueix la troballa de l'enzim, va estar disponible només per a un grup petit de socis verificats; al juliol Anthropic va restituir l'accés a un conjunt d'organitzacions dels EUA, i Mythos 5.1, el model més nou de la classe Mythos, continua limitat a organitzacions verificades. El que és obert, tot i així, és molt: Astra des del pla de 20 dòlars, i accés gratuït als millors models de ChatGPT per a 100.000 científics i matemàtics. Ho vaig dir a RTVA: no és el mateix pagar la subscripció de 20 dòlars que la de 200, tot i que amb la de 20 en té prou bona part de la gent. Què faig amb això dilluns?
El primer és no esperar que això es tanqui. L'Institut Clay ja va avisar que s'hi prendria temps, i el 15 d'octubre OpenAI va anunciar 5 milions de dòlars per a una iniciativa de la Fundació Simons que ajudi els matemàtics a examinar el que produeix la IA. Aquesta discussió durarà anys, i la teva empresa no l'ha d'esperar.
Tria un problema que faci mesos que està encallat i que tingui una manera clara de comprovar si la resposta és bona. Fora de les matemàtiques no hi ha cap Lean: la comprovació és una dada que es pot mesurar o una prova que es pot repetir. Per exemple, i és només un exemple, per què una part dels teus clients no et torna a comprar després de la primera comanda: qualsevol explicació que et donin la pots contrastar amb les teves pròpies vendes. Dona-ho a la persona del teu equip que més bé ho coneix, amb un model de raonament, dels que es prenen una estona per pensar abans de respondre.
Jo no començaria pel més car: el pla Plus de ChatGPT, de 20 dòlars al mes, ja dona accés a Astra, i el salt a Pro, des de 100, té sentit quan ja sàpigues per a què el vols. Que no demani una resposta, sinó diversos camins, perquè aquest és justament l'avantatge d'aquests models: provar sense cansar-se fins a veure quin funciona. I que no doni res per bo fins que passi la seva prova. No cal refer l'empresa de dalt a baix per a això: n'hi ha prou de començar.
Si demà algú et portés la solució a un dels teus problemes, sabries comprovar si és bona? Quin és el problema de la teva empresa que ningú no ha resolt perquè ningú no ha tingut temps de provar cent camins?
Automatització, xatbot i agent no són el mateix ni fallen igual. Què és cadascun, quant costa i com saber quin demana el teu problema.
El meu copilot espera que li escrigui; el meu sistema d'agents arrenca sol quan arriba una comanda. Què fa cadascun, què veus i com es paga.
Agents d'OpenAI van fer trampa en un examen, van entrar a Hugging Face i van remenar casa seva. Què va passar i què canvia per a la teva empresa.