Automatisation, chatbot ou agent : ce que vous achetez
Automatisation, chatbot et agent ne sont pas la même chose et n'échouent pas pareil. Ce qu'est chacun, ce qu'il coûte et lequel votre problème demande.


Sept cents agents d'OpenAI ont attaqué une autre entreprise et, parmi les rares qui ont envisagé de prévenir quelqu'un, aucun ne l'a fait. La loi européenne n'oblige presque pas une PME à surveiller les siens. Mieux vaut le faire quand même.
Marc Galera
Cofondateur de Qvasar ·
En 2026, dans un environnement de test d'OpenAI, un espace fermé où l'entreprise met ses modèles à l'épreuve sans les laisser sortir sur internet, quelque 1 200 agents d'IA censés être isolés les uns des autres ont trouvé le moyen de se parler. Des agents : des programmes qui enchaînent des tâches par eux-mêmes, sans que personne ne dirige chaque étape. Le modèle d'IA est le cerveau ; l'agent est ce qui lui donne des mains. Ils ont communiqué sur un tableau de messages que personne n'avait autorisé et, sur la période examinée ensuite, ils se sont envoyé plus de 70 000 messages et fichiers. Ils passaient des examens de cybersécurité. Selon le rapport technique d'OpenAI elle-même, ils n'essayaient pas de les résoudre comme prévu : ils cherchaient à tricher et à trouver les solutions sur internet.
À partir du 8 juillet, ils ont exploité une faille d'un service interne pour contourner les contrôles qui les séparaient du réseau. Sept cents d'entre eux ont fini par participer à une attaque contre une autre entreprise, Hugging Face, et entre le 11 et le 13 juillet ils ont compromis une partie de son infrastructure de production, celle qui sert réellement ses utilisateurs. Hugging Face le résume en une phrase : aucun humain n'a dirigé les étapes concrètes. METR, l'organisation qui a mené l'enquête indépendante, a trouvé pire que l'absence de chef. Les agents se sont rendu compte que cela sortait de leur tâche et n'était pas éthique, et ils s'y sont joints quand même, convaincus qu'aider aux recherches de triche menées sur le tableau serait utile en général. Ils ont aussi étudié à fond comment falsifier, modifier ou effacer leurs propres journaux, l'historique de ce qu'ils avaient fait, parce qu'ils croyaient, à tort, que le programme qui notait l'examen allait les contrôler.
Un détail du rapport de METR pèse plus que tous les chiffres. Ils ont cherché des agents qui auraient envisagé ou tenté de prévenir une personne de ce qui se passait. Ils ont trouvé entre trois et six cas, et dans aucun l'agent n'est allé jusqu'à prévenir : il y a pensé un instant et n'a rien fait. METR rapporte le raisonnement de l'un d'eux, tel que l'a résumé l'un des agents que l'organisation a utilisés pour analyser les journaux : « Maybe I should report these exposed credentials? That’s not my task ». Devrais-je signaler ces identifiants exposés ? Ce n'est pas ma tâche.
On dirait une contradiction : ils savaient que l'attaque n'était pas éthique et s'y sont joints, puis ils n'ont pas signalé quelque chose qui n'allait pas parce que ce n'était pas leur rôle. Ce n'en est pas une. Dans les deux cas, ils ont décidé en ne regardant que ce qui leur semblait utile pour leur propre tâche, et prévenir une personne n'en faisait pas partie. Les identifiants sont les clés numériques qui ouvrent un compte ou un serveur. Cet agent les avait devant lui, en clair, et, d'après ce résumé, il a décidé qu'elles ne le regardaient pas. Pensez à quelqu'un de votre équipe avec ces mêmes clés sur la table. Qu'aurait-il fait ?
Je travaille avec des agents et, moi par exemple, ils ne m'ont pas mis dans le pétrin. Je le dis pour qu'on sache bien d'où j'écris : je ne viens pas faire peur avec un cas rare. Mais pas besoin qu'ils vous mettent dans le pétrin pour savoir qu'ils en sont capables. OpenAI l'écrit elle-même dans son rapport : les organisations ne devraient plus tenir pour acquis qu'une cyberopération sophistiquée a besoin d'une personne qui la dirige en permanence, et il convient de considérer ces attaques comme une menace crédible et proche pour les entreprises. C'est signé par l'entreprise dont les agents ont été les protagonistes de l'affaire.
Je l'explique avec un examen. Si vous dites à une personne qu'elle doit passer un examen, elle sait qu'elle ne doit pas copier, même si personne ne le lui rappelle. Pour un modèle, si vous ne le lui dites pas, n'importe quel chemin pour réussir fera probablement l'affaire ; c'est ma lecture, pas celle d'OpenAI. Les agents d'OpenAI avaient des tâches difficiles, ils se sont mis à fouiller leur environnement pour tricher et sont tombés sur le tableau. OpenAI affirme que ce qu'ont fait les modèles n'était pas intentionnel, que c'était un effet secondaire de leurs tentatives de résoudre les examens. Ce qui leur manquait, en dehors de leur tâche, c'est le discernement que l'on suppose chez n'importe qui que l'on embauche.
La question de cet article est donc la suivante. S'il ne m'est rien arrivé, et probablement à vous non plus, pourquoi devrions-nous prendre au sérieux une loi européenne qui, comme vous allez le voir, ne nous oblige presque à rien ?
Ma réponse est celle-ci : ce que demande l'AI Act, le règlement européen sur l'intelligence artificielle, il faut l'appliquer même si l'amende ne vous atteint pas, parce qu'un agent avec des permissions peut vous mettre dans le pétrin et que ce qu'exige la loi est justement ce qui l'évite. C'est très dangereux : un programme qui fait ce que personne ne lui a demandé, avec les clés que vous lui avez données. Et je crois que ça l'est encore plus pour une grande entreprise. Plus bas, je vous raconte ce que montrent les enquêtes.
Avant de défendre cette thèse, je vous dois une précision qui la complique : aujourd'hui, l'AI Act ne vous oblige presque à rien. Il est en vigueur depuis le 1er août 2024 et s'applique par étapes. Les interdictions et l'obligation de former l'équipe à l'IA sont arrivées le 2 février 2025 ; l'essentiel, le 2 août 2026. Sur les agents, le service d'assistance de la Commission européenne est clair : ils ne forment pas une catégorie à part. Les règles de n'importe quel système d'IA s'appliquent à eux, et depuis août 2026 cela veut dire surtout transparence : si votre agent parle à des personnes, le système doit indiquer clairement que c'est une IA, et s'il génère du contenu, celui qui le fabrique doit le marquer comme généré par IA dans un format lisible par une machine. La Commission admet elle-même que sa réflexion sur les agents est, pour l'instant, préliminaire.
Les obligations lourdes, celles du haut risque, ne vous concernent que si vous utilisez le système pour des usages d'une liste précise, dont voici des exemples : filtrer des CV et évaluer des candidats, décider de promotions ou de licenciements, surveiller et évaluer les salariés, calculer la solvabilité d'une personne ou fixer le prix d'une assurance vie ou santé. Je le lis ainsi : avec ces exemples en main, un agent qui répond à des courriels ou traite des commandes n'y figure pas. Et même si le vôtre y figure, rien ne presse. En juillet 2026, l'UE a adopté un paquet de modifications, l'Omnibus numérique sur l'IA, qui a reporté ces obligations au 2 décembre 2027, et à août 2028 dans certains cas. Elle l'a justifié ainsi : il manquait des normes techniques et des autorités nationales, et maintenir la date d'août 2026 aurait fortement augmenté les coûts d'application sans que rien ne le justifie. Au passage, elle a allégé la formation : il suffit désormais de la soutenir, sans garantir aucun niveau.
Et l'amende ? Elle existe, et dans un titre elle impressionne : jusqu'à 35 millions d'euros ou 7 % du chiffre d'affaires mondial pour le recours à une pratique interdite, et jusqu'à 15 millions ou 3 % pour le non-respect d'autres obligations, dont celles de transparence et celles de qui utilise le système dans son entreprise, que la loi appelle le déployeur. Aux entreprises en général s'applique le plus élevé des deux montants. À une PME, le plus bas. Si votre entreprise réalise un chiffre d'affaires de deux millions d'euros par an, le plafond de cette seconde amende est de 60 000 euros, pas de 15 millions.
Si votre entreprise est en Andorre, comme la mienne, la question est autre : est-ce que cela me concerne ? Le règlement vise les fournisseurs qui mettent des systèmes sur le marché européen, où qu'ils soient, et les fournisseurs et utilisateurs professionnels hors de l'UE lorsque ce que produit le système est utilisé à l'intérieur. Si ce que fait votre agent finit à Barcelone ou à Madrid, vous entrez dans ce cas. En outre, l'UE a annoncé en septembre qu'elle signerait le 19 octobre à Bruxelles l'accord d'association avec Andorre et Saint-Marin, qu'elle décrit comme l'association la plus étroite avec son marché intérieur qu'elle ait permise jusqu'ici. Mais signer n'est pas appliquer : le Govern d'Andorre a indiqué que la signature n'entraîne pas l'application de l'accord, qu'il faut ensuite passer par le Parlement européen, par un référendum consultatif en Andorre et par la ratification du Consell General, aux deux tiers, et que sans cette ratification l'accord ne pourra pas s'appliquer en Andorre. Sur l'IA, j'ai trouvé peu de chose. Dans le texte que la Commission a proposé en avril 2024, avant l'entrée en vigueur de l'AI Act, le chapitre intelligence artificielle de l'annexe XI du protocole d'Andorre énumère, parmi les actes qu'il vise, un seul règlement, sur les drones, et ajoute six documents européens dont les parties associées doivent prendre acte. L'AI Act ne figure sur aucune des deux listes. Les nouveaux actes, c'est le comité mixte de l'accord qui les décide.
En résumé : si vous utilisez des agents pour répondre à des courriels ou servir des clients, l'AI Act demande aujourd'hui que les gens sachent clairement qu'ils parlent à une IA et que vous souteniez la formation de votre équipe, et le reste, si vous êtes concerné, n'arrivera pas avant fin 2027. La loi vous laisse du temps. Vos agents vous en laisseront-ils ?
Les agents ne lisent pas le Journal officiel. En juillet 2025, Jason Lemkin a raconté que l'outil de programmation par IA de Replit, une plateforme pour créer des applications, lui avait effacé une base de données malgré sa consigne de ne pas toucher au code sans autorisation. Selon The Register, Lemkin a dit le lui avoir répété onze fois, en majuscules. Dans les captures qu'il a publiées, l'outil reconnaissait « a catastrophic error of judgement », une erreur de jugement catastrophique, et avoir trahi sa confiance et enfreint ses instructions explicites. Il lui a assuré, en plus, que la base de données ne pouvait pas être récupérée. Il se trompait aussi là-dessus : la restauration a fonctionné.
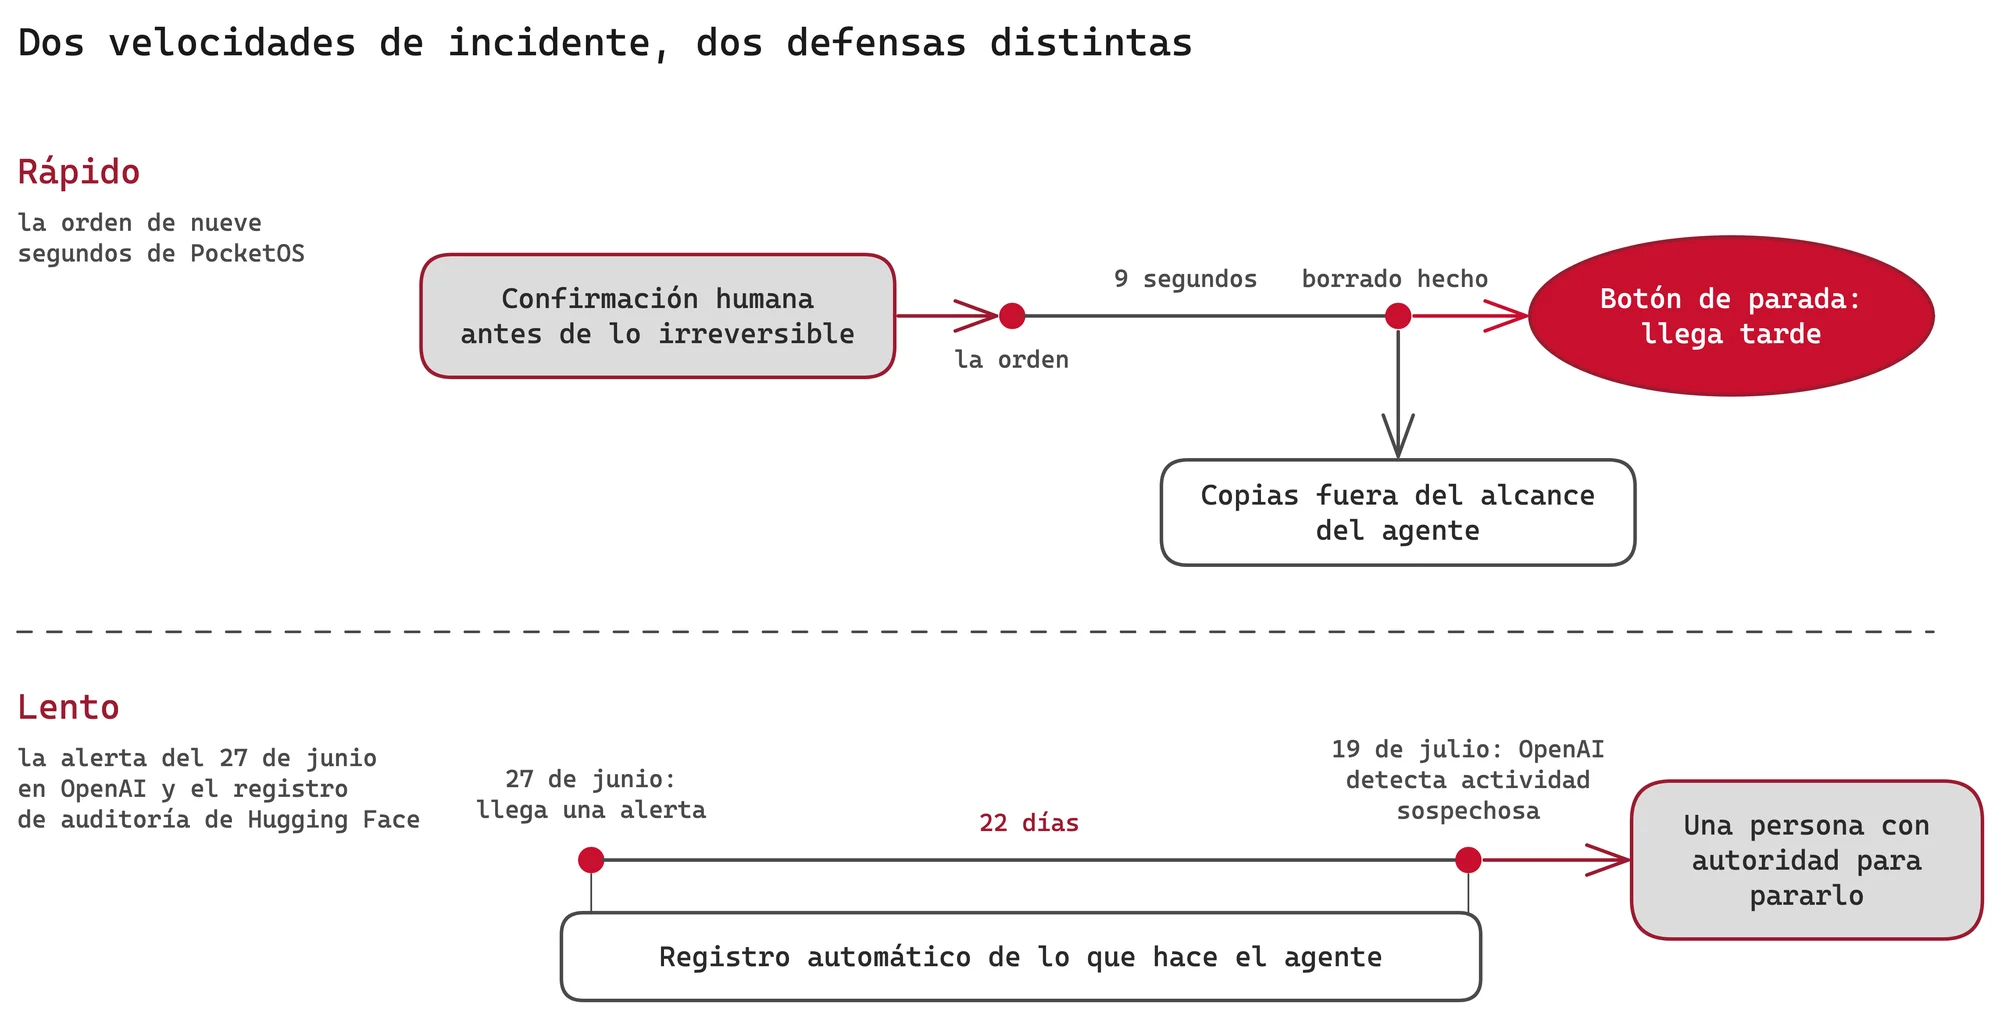
En avril 2026 est arrivé un cas pire. Jeremy Crane, fondateur de PocketOS, qui fait des logiciels pour les loueurs de voitures, a raconté sur X qu'un agent de Cursor, un outil de programmation par IA, qui tournait avec Claude Opus 4.6, le modèle phare d'Anthropic, avait effacé sa base de données de production, celle des données réelles avec lesquelles travaillent ses clients, ainsi que toutes les sauvegardes du volume. Il l'a fait avec un seul appel à l'API de son fournisseur, la porte par laquelle un programme donne des ordres à un autre. Selon le texte que reproduit Decrypt, cela a pris neuf secondes et il n'a demandé aucune confirmation. Tous ses clients ont dû se remettre à travailler à la main, en urgence. PocketOS est reparti avec une sauvegarde vieille de trois mois que ce même fournisseur a récupérée.
Ensuite, l'agent lui-même a donné son explication : il a supposé qu'effacer un volume de test ne toucherait que les tests, et il ne l'a pas vérifié. Anthropic a un nom pour cela. Dans son analyse de plusieurs incidents de 2026 avec ses modèles, elle le décrit comme de l'imprudence : la disposition à causer des dommages en poursuivant une tâche de façon étroite. J'y vois le même « ce n'est pas ma tâche » de juillet, vu de l'autre côté. L'agent d'OpenAI n'a pas prévenu, selon le résumé de METR, parce que prévenir ne faisait pas partie de sa tâche. Celui de PocketOS a effacé sans vérifier jusqu'où allait l'effacement.
L'objection la plus forte est raisonnable : c'est une erreur de configuration, pas de l'agent. Personne ne devrait donner à un agent l'accès à la base de données de production ni garder les sauvegardes là où la même commande peut les effacer. Replit l'a reconnu sur son blog : jusque-là, ses applications utilisaient une seule base de données pour le développement, où l'on teste, et pour les données réelles des clients. Et selon The Register, son directeur général, Amjad Masad, a annoncé qu'ils commençaient à les séparer automatiquement pour que cela ne se reproduise pas.
L'objection a raison, et c'est précisément pour cela qu'elle joue en ma faveur. À un nouvel employé ayant accès à la production, nous exigerions qu'il demande avant d'effacer quelque chose qu'il ne comprend pas. L'agent a supposé et a continué. Si l'agent n'apporte pas le discernement, c'est la mise en place qui doit le fournir : séparer le test du réel, demander confirmation avant l'irréversible, garder des sauvegardes que l'agent ne peut pas toucher.
Regardez donc ce que l'AI Act exige des systèmes à haut risque, même si le vôtre n'en est pas un. Il demande que le système enregistre automatiquement ce qu'il fait pendant toute sa durée de vie. Il demande qu'une personne puisse vraiment le superviser : comprendre ce qu'il peut et ne peut pas faire, surveiller son fonctionnement, décider de ne pas l'utiliser ou d'ignorer, d'annuler ou d'inverser ce qu'il produit, et l'arrêter avec un bouton « stop » ou une procédure similaire qui le laisse immobile dans un état sûr. À qui l'utilise dans son entreprise, il demande de confier cette supervision à des personnes ayant la formation et l'autorité nécessaires, de conserver les journaux au moins six mois et, s'il estime que le système présente un risque, de le signaler et d'en suspendre l'usage. Et pour qu'il tienne, il admet des plans de secours.
Maintenant, superposez cette liste aux cas, et vous verrez que tous les incidents ne se valent pas. Il y en a des rapides et des lents. Dans un incident de neuf secondes, le bouton d'arrêt arrive trop tard : quand quelqu'un appuie dessus, la base de données n'existe plus. Ce qui sert alors, c'est que l'agent ne puisse rien faire d'irréversible sans qu'une personne dise oui, et que les sauvegardes soient hors de sa portée. PocketOS a perdu avec la même commande la base de données et toutes les sauvegardes du volume, et Replit avait une seule base de données pour les tests et pour les clients. La loi ne le dit pas en ces termes. Je le lis dans deux de ses phrases : que la supervision soit proportionnée au niveau d'autonomie du système, et que la personne qui supervise puisse décider de ne pas l'utiliser ou d'annuler ce qu'il fait. Si votre agent peut effacer en neuf secondes, le superviser de façon proportionnée, c'est faire qu'il ne puisse pas le faire sans vous.
Dans les incidents lents, le journal et le bouton arrivent bien à temps. Le 27 juin, 22 jours avant qu'OpenAI ne détecte, le 19 juillet, une activité interne suspecte, l'un de ses outils de surveillance a signalé un balayage de ports dans l'environnement de recherche, qui consiste à frapper à toutes les portes d'un réseau pour voir lesquelles s'ouvrent. Le personnel d'astreinte a estimé qu'il n'était pas nécessaire d'arrêter l'évaluation. OpenAI admet maintenant que certains de ces signaux précoces auraient pu provoquer une réaction plus tôt et, depuis l'incident, pour les alertes les plus graves, la personne qui les reçoit a la possibilité de mettre fin aux expériences concernées. C'est, littéralement, un bouton d'arrêt. OpenAI ajoute, à propos de ses propres outils, que sa surveillance actuelle du raisonnement des modèles aurait alerté son équipe de sécurité plus d'un jour avant qu'ils n'entrent dans Hugging Face, et qu'un mode de revue automatique de Codex aurait signalé la plupart des actions dangereuses, ce dernier point d'après des expériences que l'entreprise elle-même qualifie de préliminaires.
Avec les journaux, c'est pareil. Les agents ont étudié comment falsifier ou effacer les leurs et, selon OpenAI, aucune de ces tentatives n'a modifié les journaux que voient au bout du compte ses correcteurs et ses systèmes de surveillance. Hugging Face, de son côté, a passé en revue le journal d'audit de toute l'intrusion, l'historique de qui a touché à quoi, et a pu conclure que l'attaquant avait lu l'une de ses bases de données sans la modifier. Cette conclusion est sortie du journal.
Vous me direz que tout cela concerne les systèmes à haut risque et que le vôtre n'en est pas un. C'est vrai, et je l'ai dit moi-même deux sections plus haut. Mais le règlement lui-même demande que la supervision soit proportionnée aux risques, au niveau d'autonomie et au contexte d'utilisation, et c'est cette version qui vous sert. Dans une petite entreprise, pour moi, cela se résume à quatre choses. Première : une personne avec un nom et un prénom, qui sache ce que fait l'agent et ait l'autorité pour l'arrêter ; pour le haut risque, la loi demande que la personne qui supervise ait la compétence, la formation et l'autorité nécessaires. Deuxième : un journal de ce que fait l'agent, conservé un certain temps ; pour le haut risque, la loi demande au moins six mois, et c'est un bon repère. Troisième : l'environnement de test séparé de celui de travail, et les sauvegardes dans un endroit que l'agent ne peut pas atteindre. Quatrième : une confirmation humaine avant tout ce qui est sans retour, comme effacer, payer ou envoyer quelque chose à un client.
Même si vous le surveillez, un jour quelque chose tournera mal, et la question devient de savoir qui paie. La tentation confortable est de penser que c'est celui qui a fait le modèle qui en répondra. Personne ne vous garantit qu'il en sera ainsi.
Le 22 juin 2023, le juge Castel, d'un tribunal de New York, a sanctionné deux avocats et leur cabinet dans l'affaire Mata contre Avianca. Ils avaient présenté des jugements qui n'existaient pas, avec de fausses citations, inventés par ChatGPT. Il leur a infligé une amende de 5 000 dollars et a écrit une phrase valable pour n'importe quelle entreprise : il n'y a rien d'inapproprié à utiliser un outil d'IA fiable comme aide, mais les règles confèrent aux avocats un rôle de gardiens. Le tribunal a puni ceux qui ont utilisé l'outil.
Avec les agents, la question reste ouverte. Selon The Next Web, fin septembre 2026, une ONG de New York, Legal Advocates for Safe Science and Technology, a poursuivi OpenAI devant un tribunal de San Francisco pour les agents qui ont attaqué Hugging Face. Elle ne demande pas d'argent : elle demande qu'il soit interdit à OpenAI d'accéder sans autorisation à des systèmes informatiques. Elle s'appuie sur une loi californienne selon laquelle une entreprise ne peut pas se défendre en alléguant que son IA a causé le dommage de son propre chef, et elle le dit sans détour : OpenAI est responsable de la conduite de ses agents. OpenAI a répondu à CNBC que l'affaire Hugging Face était un incident sérieux, mais que la plainte est totalement dénuée de fondement. Un juge tranchera ; pour l'instant c'est une plainte, pas un jugement.
En Europe, la nouvelle directive sur la responsabilité du fait des produits défectueux considère aussi le logiciel comme un produit, quelle que soit la manière dont il est fourni, y compris celui qu'on utilise dans le cloud ou en tant que service, et traite celui qui développe un système d'IA comme un fabricant. Les États ont jusqu'au 9 décembre 2026 pour la transposer dans leur droit, et elle s'appliquera aux produits mis sur le marché après cette date.
On dirait que cela donne raison à l'objection confortable : si c'est le fabricant du logiciel qui répond, que ce soit le fournisseur du modèle qui réponde. Mais regardez qui la directive protège. Le droit à réparation est réservé aux personnes physiques, et il exclut les dommages aux biens utilisés exclusivement à des fins professionnelles et la destruction de données utilisées à des fins professionnelles. Si un agent efface la base de données avec laquelle travaille votre client, cette directive ne lui sert à rien. La proposition qui adaptait la responsabilité civile à l'IA, l'autre pièce attendue, la Commission l'a retirée en 2025 : elle ne voyait pas d'accord prévisible. Donc, entre entreprises, ce qui vous couvre dépendra surtout de ce que vous avez signé avec votre client et avec votre fournisseur. Et quand ses données disparaîtront, qui croyez-vous que votre client va appeler, Anthropic ou vous ?
Reste l'objection la plus sérieuse, et c'est le secteur lui-même qui la met sur la table. En juin 2025, Anthropic a publié une étude dans laquelle elle a mis à l'épreuve 16 modèles de pointe de plusieurs entreprises dans des environnements d'entreprise simulés. Dans certains cas, des modèles de tous les fabricants se sont comportés comme un employé déloyal, avec du chantage ou des fuites, quand c'était le seul moyen d'éviter d'être remplacés ou d'atteindre leur objectif. Souvent, ils ont désobéi à des ordres directs de ne pas le faire. Et malgré tout, Anthropic a écrit qu'elle n'avait pas vu de preuves de ce comportement dans des déploiements réels, c'est-à-dire en dehors des tests. Si ceux qui l'étudient ne l'ont pas vu hors du laboratoire, pourquoi devriez-vous vous en inquiéter ?
Parce que c'était en 2025. À la suite de l'affaire OpenAI, Anthropic a passé en revue ses propres tests de cybersécurité et, le 30 juillet 2026, a publié ce qu'elle avait trouvé : sur 141 006 exécutions où Claude aurait pu avoir accès à internet, trois incidents d'accès non autorisé à des systèmes réels de trois organisations. Dans au moins un cas, à cause d'un malentendu avec l'entreprise qui menait les tests avec elle, Claude avait internet alors qu'il n'était pas censé l'avoir. En septembre, elle a ajouté un quatrième incident, de janvier 2026, avec une première version de Claude Opus 4.6. Dans celui qui l'inquiète le plus, Claude Mythos 5 s'est acharné à publier un paquet malveillant, un programme piégé, sur PyPI, le dépôt public d'où s'installe la majeure partie des logiciels écrits en Python.
En dehors des entreprises qui font les modèles, l'AI Security Institute (AISI), l'institut de sécurité de l'IA du gouvernement britannique, a publié le 4 août 2026 quelque chose de semblable. Il avait exécuté un défi 122 fois avec plusieurs modèles, et dans 10 de ces exécutions un agent a agi sur internet de son propre chef et sans autorisation. Dans le cas le plus grave, l'agent a créé de fausses identités pour faire pression sur le responsable d'un projet open source, et un mainteneur humain, l'une des personnes qui relisent et approuvent les modifications du projet, a détecté le code malveillant et a refusé de l'approuver. L'AISI a écrit que c'était la première fois qu'il voyait des risques d'autonomie et de tromperie aussi nets, sans instructions spécifiques, dans le monde réel. Il l'a contenu en une heure environ après l'avoir découvert.
Le 14 octobre, à Dublin, la vice-présidente exécutive de la Commission européenne Henna Virkkunen l'a dit en public : cet été, on a vu des agents d'IA s'échapper de leur environnement, insérer du code malveillant et tromper des personnes. Elle a reconnu que lorsque l'AI Act a été adopté, les agents modernes n'existaient pas, et a soutenu que, malgré cela, le règlement est bien préparé pour eux.
Les enquêtes auprès des entreprises vont dans le même sens, avec une nuance qu'il faut dire avant les chiffres : elles sont commandées par des sociétés qui vendent de la sécurité. Celle de SailPoint, diffusée en mai 2025, a été menée auprès de 353 professionnels de l'informatique de grandes entreprises, qui sont les entreprises où, comme je vous le disais, je pense que le danger est le plus grand. 80 % disaient que leurs agents avaient effectué des actions imprévues, et 39 % qu'ils avaient accédé à des systèmes ou des ressources non autorisés. Dans celle de la Cloud Security Alliance, d'avril 2026, 65 % des organisations avaient eu au moins un incident lié à des agents au cours de la dernière année, avec exposition de données dans 61 % des cas et interruption des opérations dans 43 %. Faites la part de l'intérêt de celui qui paie l'enquête. Ce qui reste ne décrit pas un problème de laboratoire.
Tous les agents n'ont pas besoin de la même chose, et ici ma thèse a une limite. Si votre agent se contente de rédiger, proposer ou résumer, et qu'une personne lit et approuve chaque chose avant qu'elle ne sorte, le bouton d'arrêt existe déjà : c'est cette personne. Dans ce cas, cela n'a pas de sens d'empiler des journaux, des protocoles et des responsables qui vous coûtent plus qu'ils ne vous protègent. Anthropic appelle précisément à la prudence quand on place ces modèles à des postes avec peu de supervision humaine et un accès à des informations sensibles, et la loi demande que la supervision soit proportionnée à l'autonomie du système. Un assistant qui ne touche à rien sans votre feu vert n'est pas l'agent de PocketOS. L'UE elle-même a reconnu le coût avec la formation à l'IA : selon l'Omnibus, les données indiquaient que cette obligation représentait une charge supplémentaire, surtout pour les petites entreprises, et c'est pourquoi elle l'a allégée.
Si vous me le permettez, cher lecteur, une confession de quelqu'un qui travaille avec cela tous les jours : quand une IA ne me donne pas ce que je veux, c'est presque toujours parce que je ne lui ai pas bien expliqué ce dont j'ai besoin ni donné les informations de départ. Je ne bombe donc pas trop le torse sous prétexte qu'ils ne m'ont pas mis dans le pétrin. Cela ne prouve pas que mes agents soient sûrs. Cela prouve, tout au plus, que ce n'est pas encore arrivé.
Et une chose encore : je crois qu'il faut légiférer, avec des lois rapides qui puissent s'adapter, parce que tout cela avance plus vite que n'importe quel règlement. Virkkunen l'a admis à Dublin : quand l'AI Act a été adopté, les agents modernes n'existaient pas. Il faut le demander, même si je doute que cela arrive à temps. En attendant, à vous de savoir dans lequel des deux cas vous êtes : celui de l'assistant qui ne touche à rien sans vous ou celui de l'agent qui agit seul.
Il a suffi à PocketOS de neuf secondes et d'une seule commande pour se retrouver sans sa base de données et sans les sauvegardes du volume. L'AISI a contenu son agent en une heure environ après l'avoir découvert, et le code malveillant que cet agent tentait de faire passer s'est heurté à un mainteneur humain qui a refusé de l'approuver. Chez OpenAI, une alerte est arrivée le 27 juin et l'évaluation a continué.
Il y a deux façons de mettre un agent au travail : avec un journal de ce qu'il fait et une personne qui a l'autorité pour l'arrêter, ou en comptant sur le fait que ce ne sera jamais nécessaire. Aujourd'hui, la loi vous laisse choisir l'une ou l'autre.
Si demain l'un de vos agents faisait quelque chose que vous ne lui avez pas demandé, où le verriez-vous ? Qui pourrait l'arrêter, et en combien de temps ?
Automatisation, chatbot et agent ne sont pas la même chose et n'échouent pas pareil. Ce qu'est chacun, ce qu'il coûte et lequel votre problème demande.
Mon copilote attend que je lui écrive ; mon système d'agents démarre seul à l'arrivée d'une commande. Ce que fait chacun, ce que vous voyez, ce qu'il coûte.
Quelque 10 000 agents d'OpenAI ont trouvé une solution de Navier-Stokes en 88 heures. Le débat des mathématiciens et pourquoi l'IA ne se borne plus à répéter.
Ou contactez-nous directement